Ambos platos se cocinan igual que en 2018 excepto por dos diferencias: se basan en las encuestas de 2022, obviamente, y algunas variables como el tipo de encuesta ahora incluyen mezclas (telefónica y presencial) y un nuevo tipo digital que lleva a cabo AtlasIntel.
Como todos los platos, si se cocinan con nuevos ingredientes cuando salgan más encuestas, los resultados serán diferentes. Ambos platos dan resultados muy similares, aunque procesan la información de manera diferente. Hay muy poca variabilidad entre las encuestas.
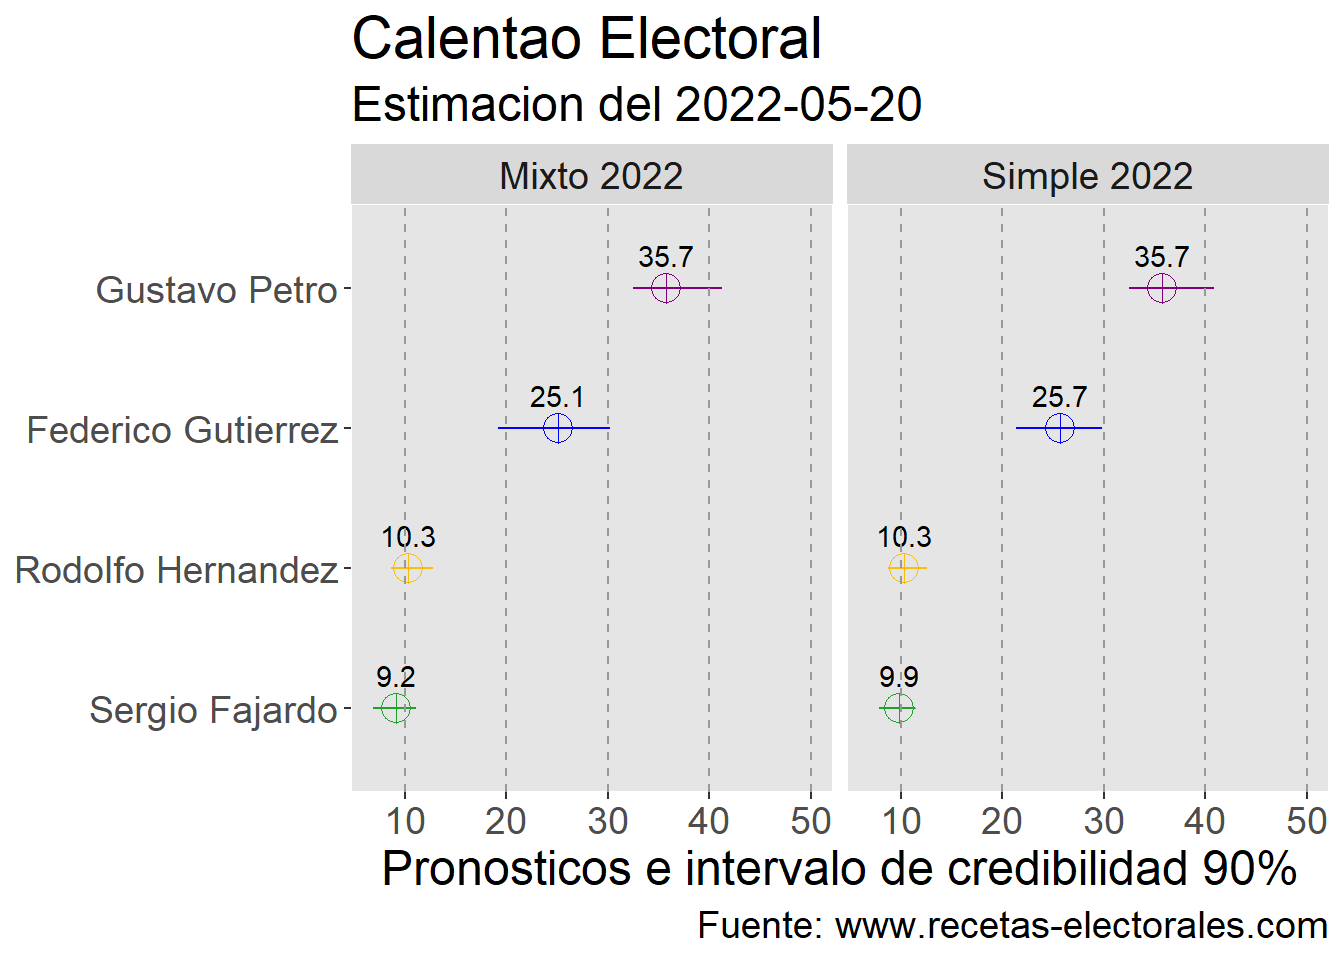
Leemos los resultados precalculados del Calentao y resumimos cada modelo por su media e intervalo de credibilidad del 80% (p10–p90), uniendo el nombre de cada candidato.
2
Graficamos los pronósticos (punto = media, barra = intervalo 90%) en paneles por plato (Simple/Mixto).
Calentao 2022
Ingredientes
El Calentao usa las encuestas públicamente disponibles desde el 11 de marzo de 2022.
Leemos y alistamos los datos como en 2018: seleccionamos columnas, filtramos el periodo entre consulta y primera vuelta, pasamos a formato largo, calculamos márgenes, días transcurridos (dd) e indicadores de tipo de encuesta.
2
Separamos un data frame por candidato (Petro, Gutiérrez, Fajardo, Hernández, Betancourt) para alimentar los modelos.
Estimación
Abajo va un ejemplo del Plato Simple para el candidato Federico Gutierrez, pero es el mismo para todos los demas. Utiliza el data frame fg_calentao, así como los priors \(\small\mu_{candidato}=23.6\) y \(\small\sigma_{candidato}=4.8\). Toda la receta va en el siguiente objeto fg_simple.stan.
Compilamos el modelo Stan del Plato Simple (fg_simple.stan).
2
Ajustamos el modelo para Federico Gutiérrez con muestreo MCMC (4 cadenas), pasando los datos del data frame fg_calentao.
Veamos en detalle el muestreo y los resultados.
Ver código
library(bayesplot)library(posterior)bayesplot::color_scheme_set("blue")# Crear matriz de muestras de la distribucion posteriorfg_simple_posterior <- posterior::as_draws_df(fg_simple_fit)#Trace plot para los parametros de interesbayesplot::mcmc_trace(fg_simple_posterior,pars=ggplot2::vars(tidyselect::starts_with("m[")))
1
Extraemos las muestras posteriores del ajuste en formato draws.
2
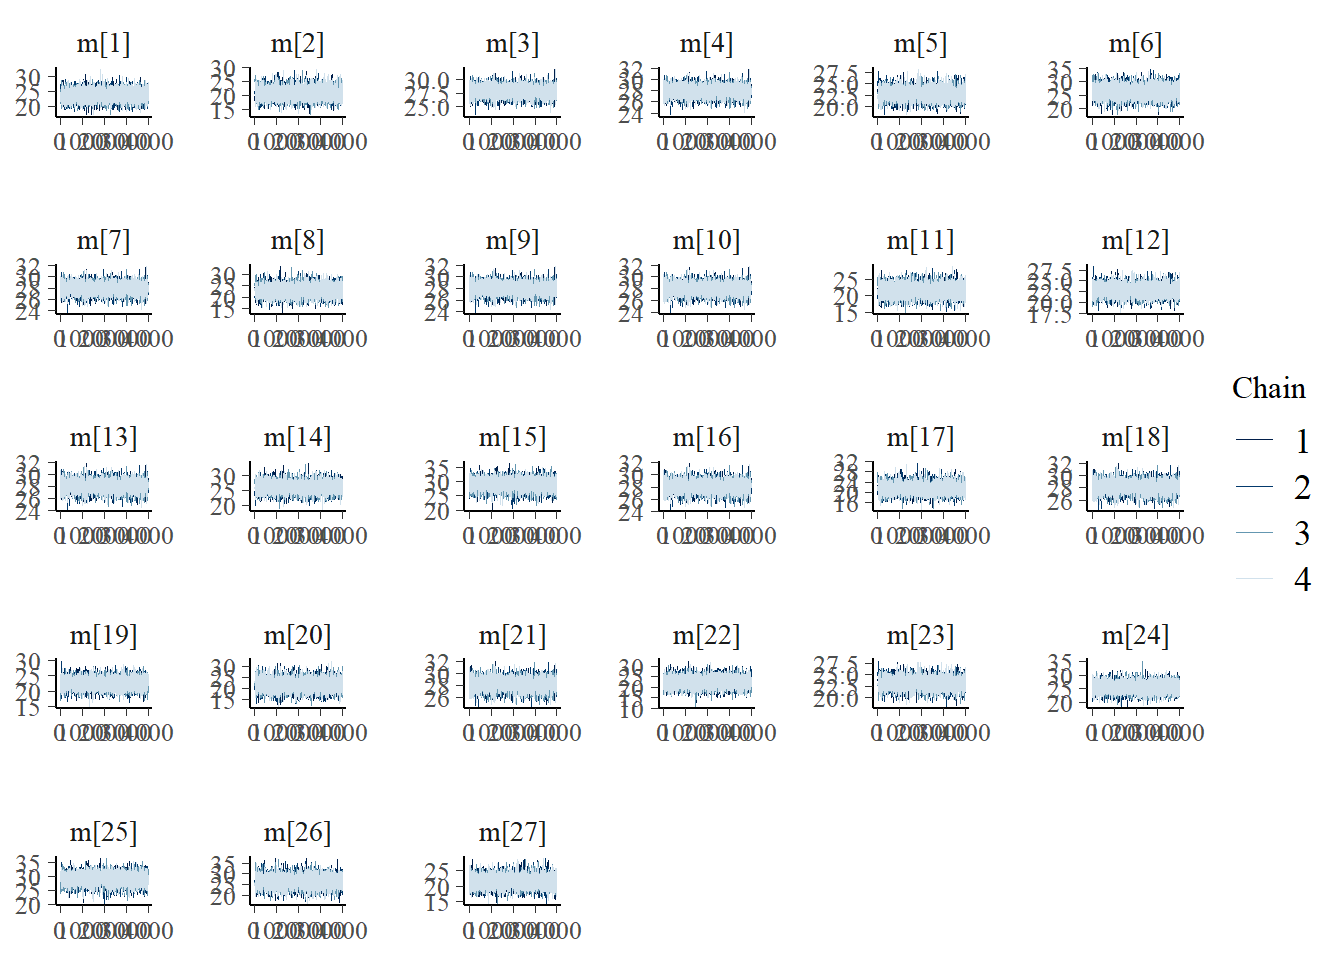
Traceplot de las medias estimadas m[i] para diagnosticar la convergencia del muestreo.
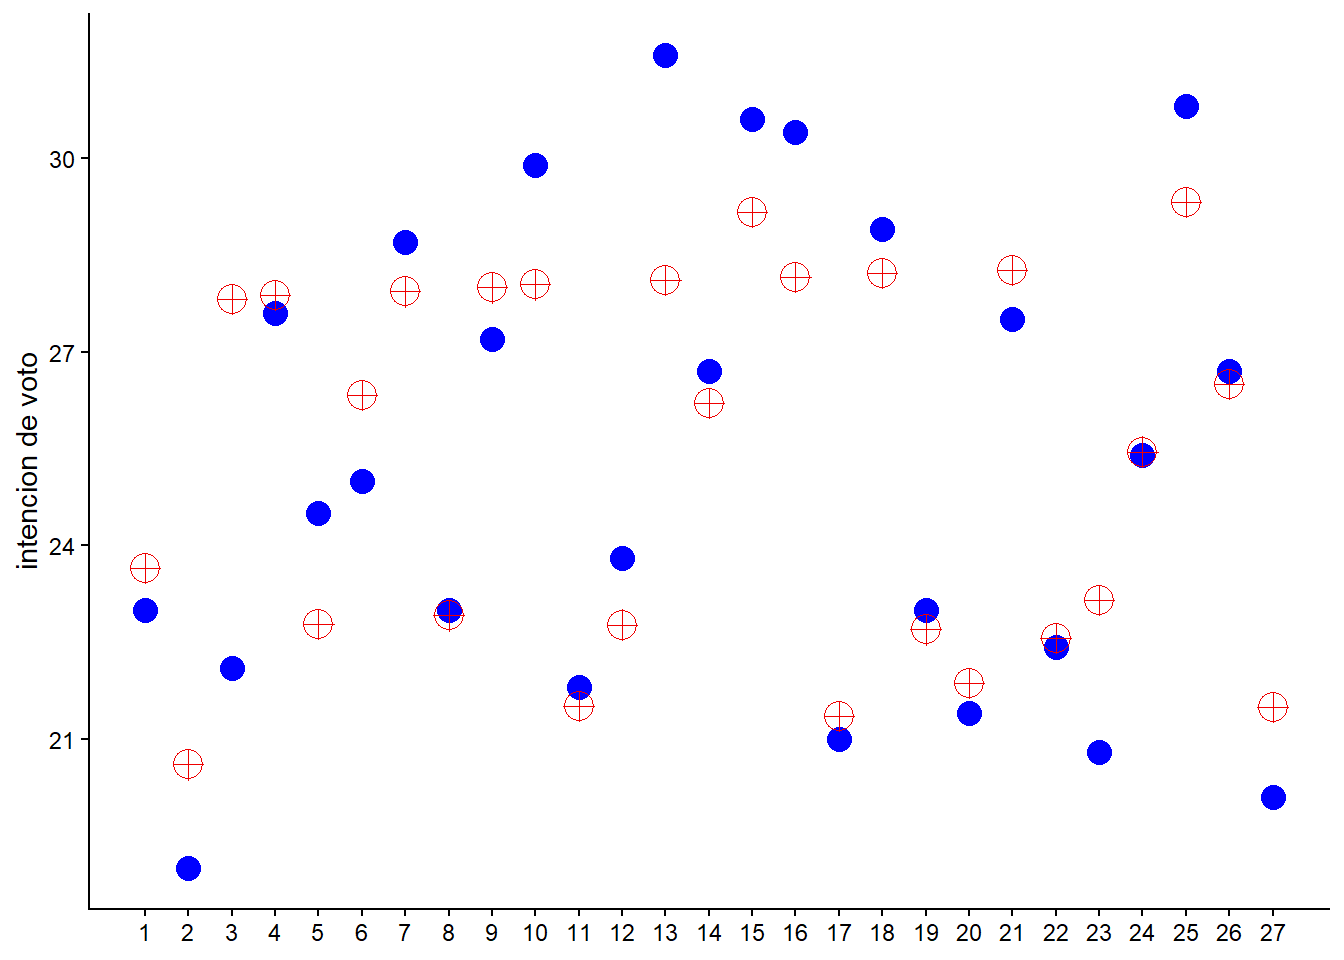
Tomamos la media posterior de cada m[i] (estimación del modelo) y la unimos con la intención de voto observada de cada encuesta.
2
Graficamos observado (azul) vs estimado (rojo) por encuesta para evaluar el ajuste.
Calentao: Parámetros vs Observaciones
Ñapa: Estimación del Calentao con ulam de rethinking
La abstrusa representación del código en RStan puede ser intimidante. Es un lenguaje que da mucha flexibilidad, pero al costo de no poder comunicarla sino al que conoce muy bien la semántica de Stan.
Así que abajo incluyo el plato mixto del calentao usando una de las funciones de la 2da edición del increíble paquete rethinking de Richard McElreath.
El mismo Plato Mixto pero expresado con rethinking::ulam: la fórmula alist() declara la verosimilitud normal, el predictor con efectos por encuestadora correlacionados (multi_normal con prior lkj_corr) y los priors; data= pasa los ingredientes y se ajusta con 4 cadenas.
Notas
Ingrid Betancourt adhirió a la campaña de Rodolfo Hernández el 20 de mayo de 2022, y desde entonces se saca de las recetas electorales.↩︎