El Ajiaco2 aumentado con tendencias y efectos de casas encuestadoras
Autor/a
Afiliación
Recetas Electorales
Análisis independiente
Fecha de publicación
13 de abril de 2026
Fecha de última modificación
16 de junio de 2026
“Don’t ask why you should use a multilevel model. Ask instead, Why not?.” –Richard McElreath
Introduciendo la Cazuela
La Cazuela es una extensión del Ajiaco2 que incorpora covariables al modelo Dirichlet-Multinomial, de manera similar a un modelo lineal generalizado (GLM). Mientras que el Ajiaco2 estima una sola proporción pooled \(\mathbf{p}\) común a todas las encuestas, la Cazuela permite que las proporciones varíen en función de:
Tendencia temporal: ¿Cómo ha cambiado el apoyo a cada candidato a lo largo del tiempo?
Efecto casa encuestadora: ¿Cada encuestadora tiene un sesgo sistemático hacia o en contra de ciertos candidatos?
El resultado es un modelo que no solo estima el estado actual de las preferencias electorales sino que también captura la dinámica temporal y corrige por las diferencias sistemáticas entre encuestadoras.
Recuperamos las dimensiones del modelo: número de encuestas J, de candidatos K y los nombres de columna.
2
Construimos los nombres de los parámetros p[J,k] correspondientes a la encuesta más reciente (J).
3
Extraemos esas columnas del posterior, las pasamos a formato largo y calculamos la media posterior de cada candidato, uniendo nombre y color.
4
Ordenamos los candidatos por su media posterior.
5
Definimos los resultados reales de la primera vuelta para superponerlos.
6
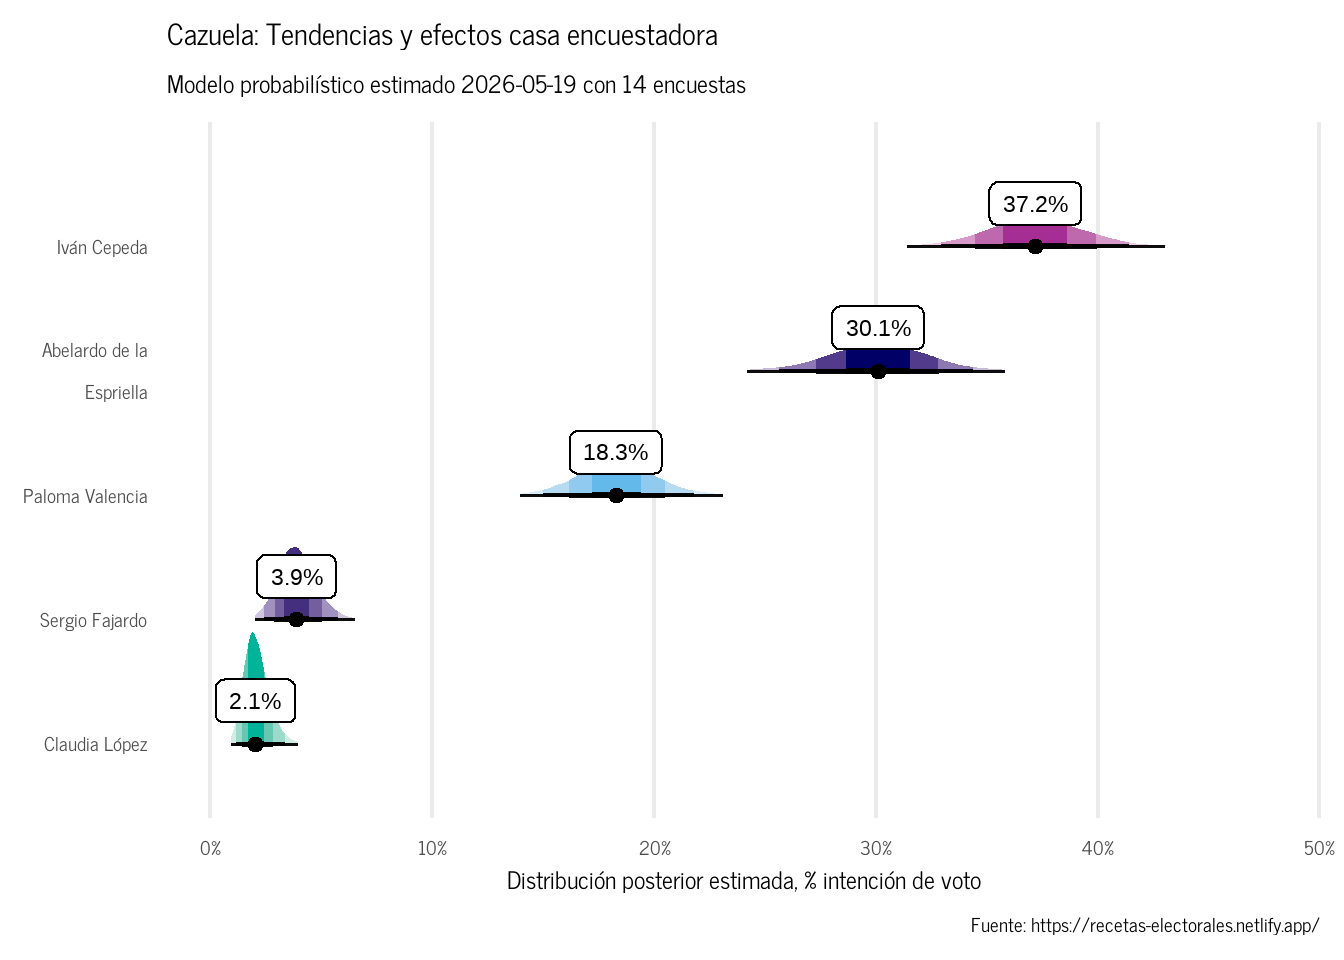
Construimos el gráfico base (proporción posterior en X, candidato en Y).
7
Capa principal: distribuciones posteriores como slabs con intervalos creíbles (50/80/95/99%).
8
Etiqueta con la media posterior de cada candidato.
9
Marcador vertical con el resultado real de cada candidato.
10
Etiqueta con el porcentaje real obtenido.
11
Escalas: colores de marca, eje X en porcentaje, nombres ajustados y rampa de intervalos creíbles.
12
Títulos, subtítulo (fecha y número de encuestas) y nota de fuente.
13
Tema minimalista con tipografía de marca y sin leyenda.
Figura 1: Cazuela: Dirichlet-Multinomial con covariables
Valencia o De la Espriella? Competencia probabilística
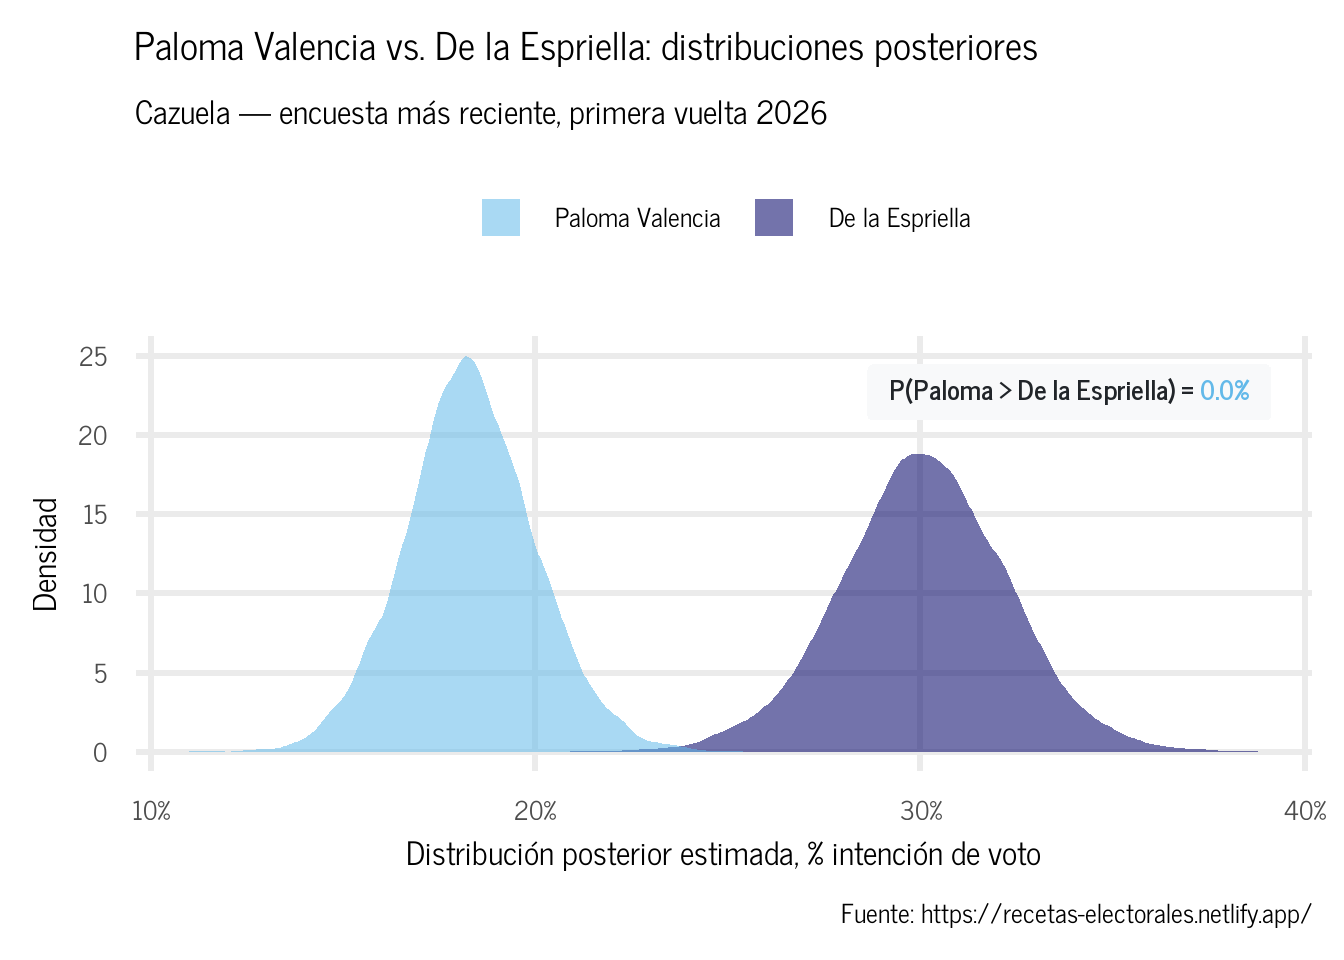
Una ventaja del enfoque bayesiano es que las comparaciones directas entre candidatos son triviales: basta con calcular la fracción de draws en los que la proporción de un candidato supera la del otro.
Según la Cazuela a 24 de mayo de 2026, la probabilidad posterior de que Paloma Valencia obtenga más votos que De la Espriella en primera vuelta es 1.0%.
Ver código
library(ggtext)draws_comp |> tidyr::pivot_longer(cols =c(p_cand_pv, p_cand_adle),names_to ="candidato",values_to ="prop" ) |> dplyr::mutate(color_cand = dplyr::case_when( candidato =="p_cand_pv"~"#63B9E9", candidato =="p_cand_adle"~"#000066" ) ) |> ggplot2::ggplot(ggplot2::aes(x = prop, fill = color_cand)) + ggplot2::geom_density(alpha =0.55, color =NA) + ggplot2::scale_x_continuous(labels = scales::percent_format(accuracy =1)) + ggplot2::scale_fill_identity(guide ="legend",labels =c("#63B9E9"="Paloma Valencia", "#000066"="De la Espriella"),breaks =c("#63B9E9", "#000066") ) + ggtext::geom_richtext(data = tibble::tibble(x =Inf, y =Inf), ggplot2::aes(x = x, y = y,label =sprintf("<b>P(Paloma > De la Espriella) = <span style='color:#63B9E9'>%.1f%%</span></b>", prob_pv_gt_adle *100 ) ),inherit.aes =FALSE,hjust =1.1,vjust =1.5,size =7,family ="news-cycle",fill ="#F8F9FA",color ="#212529",label.color =NA,label.padding = ggplot2::unit(c(0.4, 0.6, 0.4, 0.6), "lines") ) + ggplot2::labs(title ="Paloma Valencia vs. De la Espriella: distribuciones posteriores",subtitle ="Cazuela — encuesta más reciente, primera vuelta 2026",x ="Distribución posterior estimada, % intención de voto",y ="Densidad",fill =NULL,caption ="Fuente: https://recetas-electorales.netlify.app/" ) + ggplot2::theme_minimal(base_size =24) + ggplot2::theme(text = ggplot2::element_text(family ="news-cycle"),panel.grid.minor = ggplot2::element_blank(),legend.position ="top" )
1
Cargamos ggtext para rotular con texto enriquecido (HTML) dentro del gráfico.
2
Tomamos las muestras posteriores de Paloma Valencia y De la Espriella (encuesta más reciente), las pasamos a formato largo y les asignamos su color de marca.
3
Construimos el gráfico base y dibujamos la densidad posterior de cada candidato.
4
Eje X en porcentaje y leyenda con los nombres asociados a cada color.
5
Anotación enriquecida con la probabilidad posterior P(Paloma > De la Espriella).
6
Títulos, ejes y nota de fuente.
7
Tema minimalista con tipografía de marca y leyenda arriba.
Figura 2: Distribuciones posteriores de Paloma Valencia y De la Espriella (encuesta más reciente).
Tendencia temporal
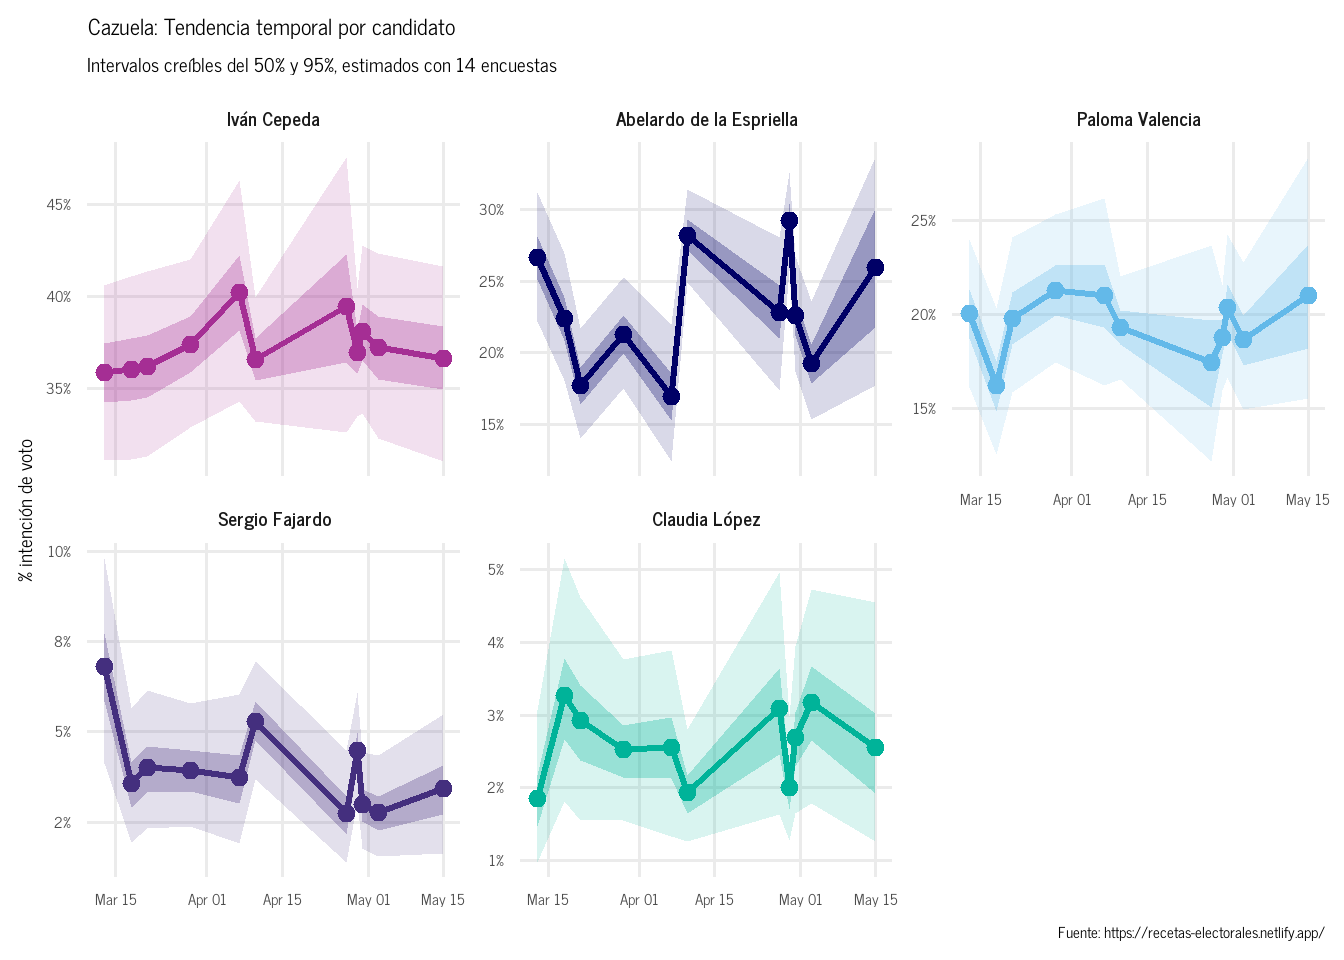
La gran ventaja de la Cazuela sobre el Ajiaco2 es que podemos visualizar cómo han cambiado las proporciones estimadas a lo largo del tiempo, corrigiendo por el efecto casa de cada encuestadora Figura 3.
Ver código
# Extraer p[j,k] para todas las encuestas ####draws_all <- cazuela_fit |> posterior::as_draws_df() |> tibble::as_tibble()# Construir data.frame largo con p[j,k] para cada draw y encuestap_draws <- purrr::map_dfr(1:J, function(j) {# Seleccionar columnas exactas p[j,1], p[j,2], ..., p[j,K] cols_j <-paste0("p[", j, ",", 1:K, "]") draws_all |> dplyr::select(dplyr::all_of(cols_j)) |> dplyr::rename_with(~ cand_names, .cols = dplyr::everything()) |> dplyr::mutate(.draw = dplyr::row_number(), .stan_idx = j)}) |> dplyr::left_join( encuestas_meta |> dplyr::mutate(.stan_idx = dplyr::row_number()),by =".stan_idx" ) |> dplyr::select(-".stan_idx") |> tidyr::pivot_longer(cols = dplyr::all_of(cand_names),names_to ="candidato",values_to ="prop" ) |> dplyr::mutate(cod = stringr::str_sub(candidato, start =6L)) |> dplyr::left_join(candidatos_2026, by =c("cod")) |> dplyr::filter(cod !="ruido")# Resumir por fecha y candidatop_summary <- p_draws |> dplyr::group_by(fecha, nombre, color_cand, cod) |> dplyr::summarise(media =mean(prop),q025 =quantile(prop, 0.025),q975 =quantile(prop, 0.975),q25 =quantile(prop, 0.25),q75 =quantile(prop, 0.75),.groups ="drop" )# Orden global de candidatos por media posterior (usado en todas las gráficas)orden_candidatos <- p_summary |> dplyr::group_by(nombre) |> dplyr::summarise(media_global =mean(media), .groups ="drop") |> dplyr::arrange(dplyr::desc(media_global)) |> dplyr::pull(nombre)resultados_caz <- tibble::tribble(~nombre, ~color_cand, ~resultado,"Iván Cepeda", colores_2026[["ic"]], 0.4092,"Abelardo de la Espriella", colores_2026[["adle"]], 0.4372,"Paloma Valencia", colores_2026[["pv"]], 0.0692,"Sergio Fajardo", colores_2026[["sf"]], 0.0426,"Claudia López", colores_2026[["cl"]], 0.0095) |> dplyr::mutate(nombre =factor(nombre, levels = orden_candidatos))p_summary |> dplyr::mutate(nombre =factor(nombre, levels = orden_candidatos)) |> ggplot2::ggplot(ggplot2::aes(x = fecha, y = media, color = color_cand, fill = color_cand)) + ggplot2::geom_ribbon(ggplot2::aes(ymin = q025, ymax = q975), alpha =0.15, color =NA) + ggplot2::geom_ribbon(ggplot2::aes(ymin = q25, ymax = q75), alpha =0.3, color =NA) + ggplot2::geom_line(linewidth =1.2) + ggplot2::geom_point(size =2.5) + ggplot2::geom_hline(data = resultados_caz, ggplot2::aes(yintercept = resultado),linetype ="dashed", color ="#333333", linewidth =0.8,inherit.aes =FALSE ) + ggplot2::geom_label(data = resultados_caz, ggplot2::aes(x =max(p_summary$fecha),y = resultado,label = scales::percent(resultado, accuracy =0.1),fill = color_cand ),hjust =1.1,color ="white",size =3.5,fontface ="bold",label.size =0,label.padding = ggplot2::unit(0.2, "lines"),inherit.aes =FALSE ) + ggplot2::scale_color_identity() + ggplot2::scale_fill_identity() + ggplot2::scale_y_continuous(labels = scales::percent_format(accuracy =1)) + ggplot2::facet_wrap(~ nombre, scales ="free_y", ncol =3) + ggplot2::labs(title ="Cazuela: Tendencia temporal por candidato",subtitle =paste0("Intervalos creíbles del 50% y 95%, estimados con ", dplyr::n_distinct(encuestas_2026$encuesta_id), " encuestas"),caption ="Fuente: https://recetas-electorales.netlify.app/",x =NULL,y ="% intención de voto" ) + ggplot2::theme_minimal(base_size =14) + ggplot2::theme(text = ggplot2::element_text(family ="news-cycle"),panel.grid.minor = ggplot2::element_blank(),strip.text = ggplot2::element_text(face ="bold", size =14),legend.position ="none" )
1
Extraemos todas las muestras posteriores (draws) del modelo.
2
Para cada encuesta j, seleccionamos sus columnas p[j,k], las unimos con los metadatos (fecha, encuestadora) y pasamos a formato largo por candidato.
3
Resumimos por fecha y candidato: media posterior e intervalos creíbles del 50% y 95%.
4
Definimos un orden global de candidatos por su media posterior (común a todos los gráficos).
5
Definimos los resultados reales de la primera vuelta para superponerlos.
6
Construimos el gráfico base (fecha en X, intención media en Y).
7
Bandas de incertidumbre: intervalo creíble del 95% (claro) y del 50% (oscuro), más línea y puntos de la media.
8
Línea horizontal punteada con el resultado real de cada candidato y su etiqueta.
9
Un panel (facet) por candidato con eje Y libre.
10
Títulos, subtítulo (número de encuestas) y nota de fuente.
11
Tema minimalista con tipografía de marca y sin leyenda.
Figura 3: Tendencia temporal estimada por la Cazuela
Efectos de casa
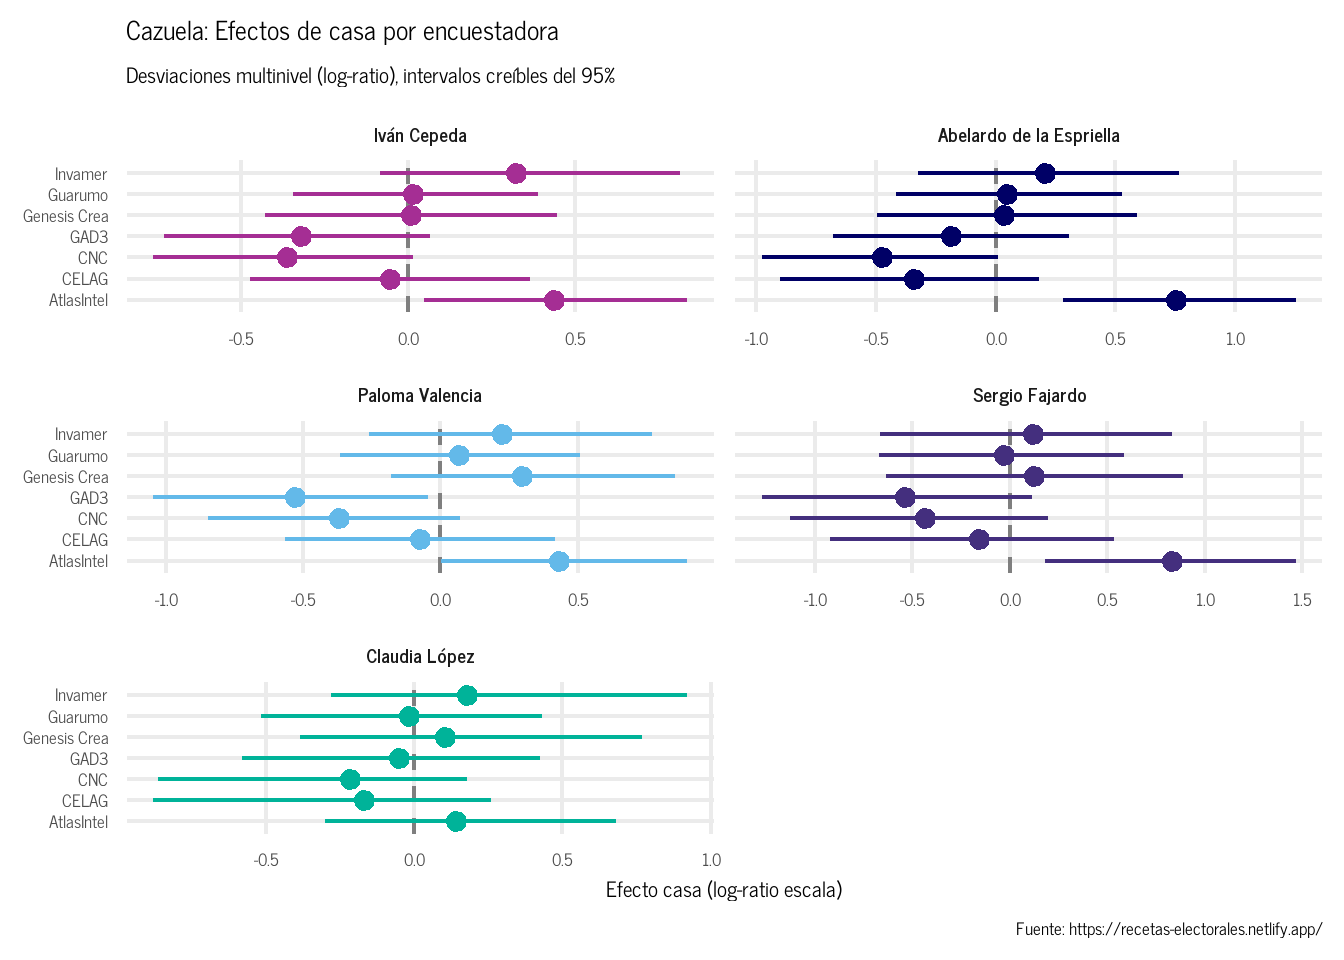
Cada encuestadora tiene un sesgo sistemático implícito. La Cazuela modela estos efectos de casa como un modelo multinivel de efectos aleatorios: cada vector \(\boldsymbol{\delta}_h \in \mathbb{R}^{K-1}\) se extrae de una distribución normal multivariada con matriz de covarianza estimada vía descomposición LKJ. Esto permite que el modelo aprenda si una encuestadora que sobreestima a un candidato tiende a subestimar a otro Figura 4.
Recuperamos las dimensiones: K-1 log-ratios y H encuestadoras.
2
Extraemos los parámetros delta[k,h] del posterior, decodificamos los índices candidato/encuestadora y les unimos nombre y color.
3
Resumimos cada efecto de casa: media posterior e intervalo creíble del 95%.
4
Construimos el gráfico (efecto de casa en X, encuestadora en Y).
5
Línea de referencia en cero (sin sesgo) y rangos posteriores con geom_pointrange.
6
Un panel (facet) por candidato con eje X libre.
7
Títulos, ejes y nota de fuente.
8
Tema minimalista con tipografía de marca y sin leyenda.
Figura 4: Efectos de casa estimados por la Cazuela
El partial pooling en acción
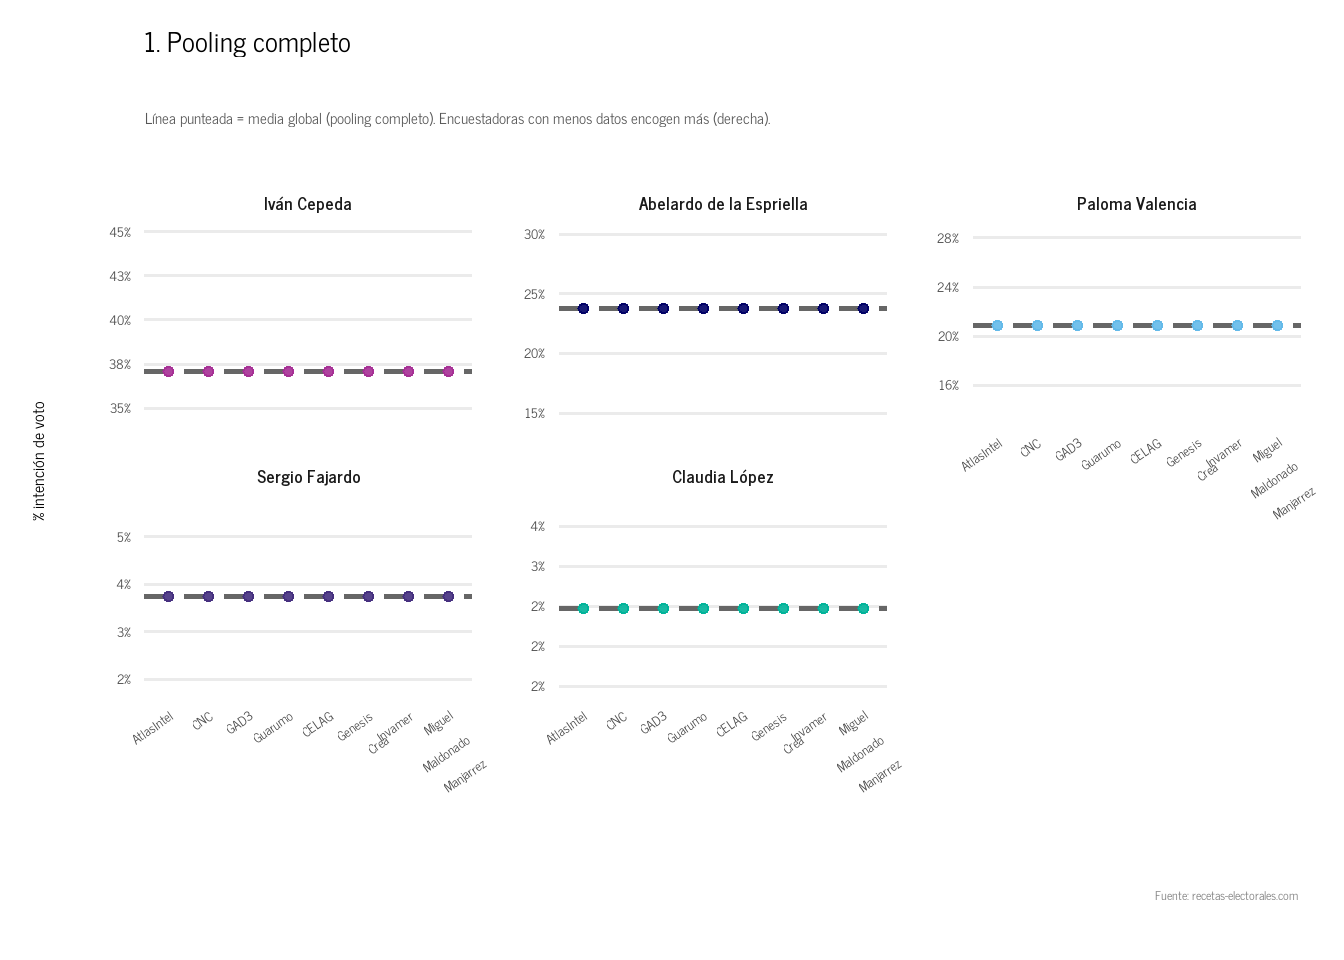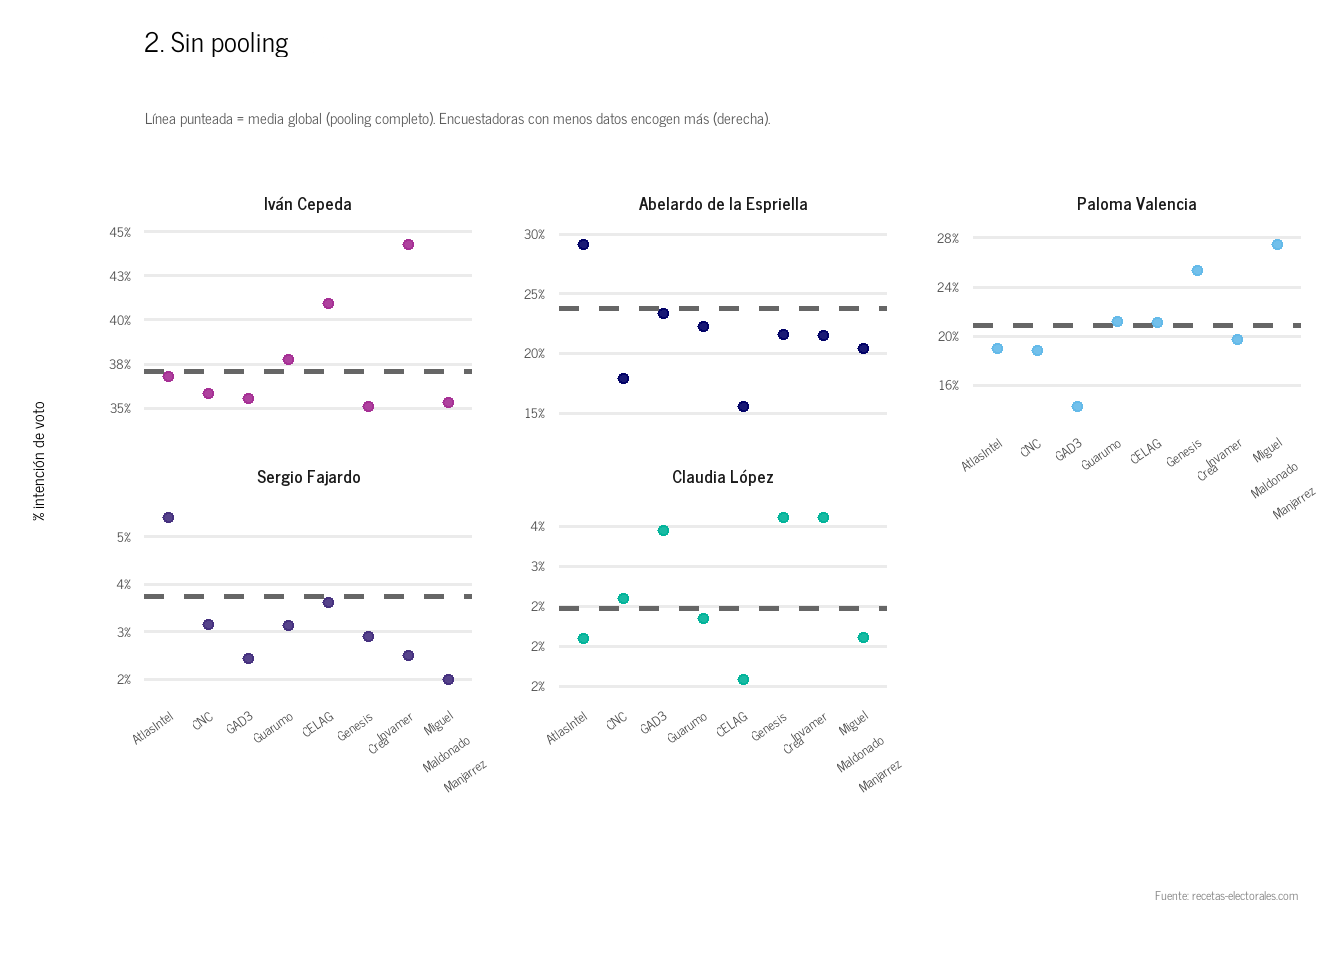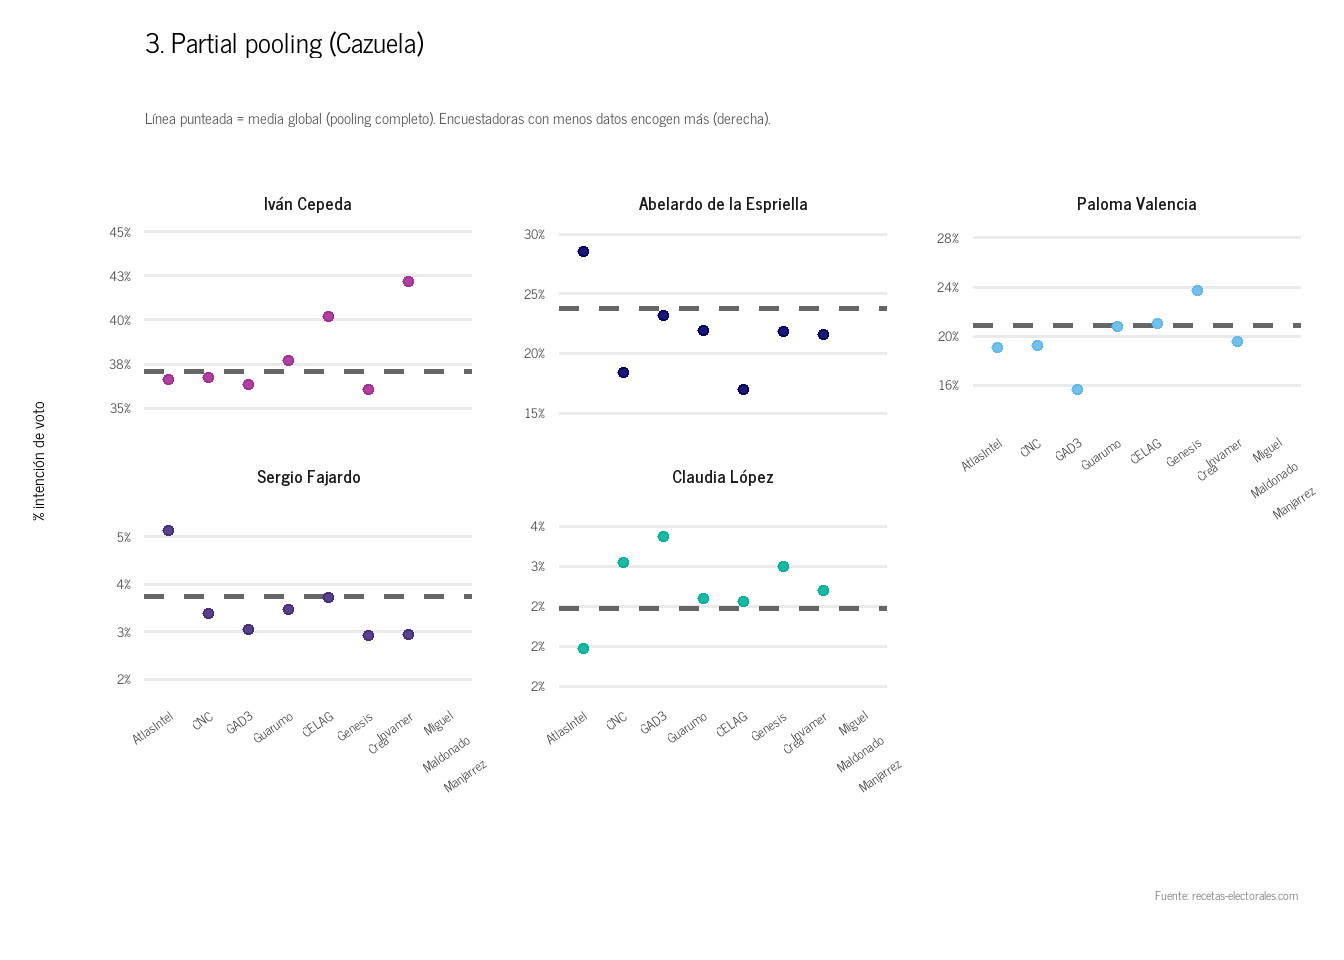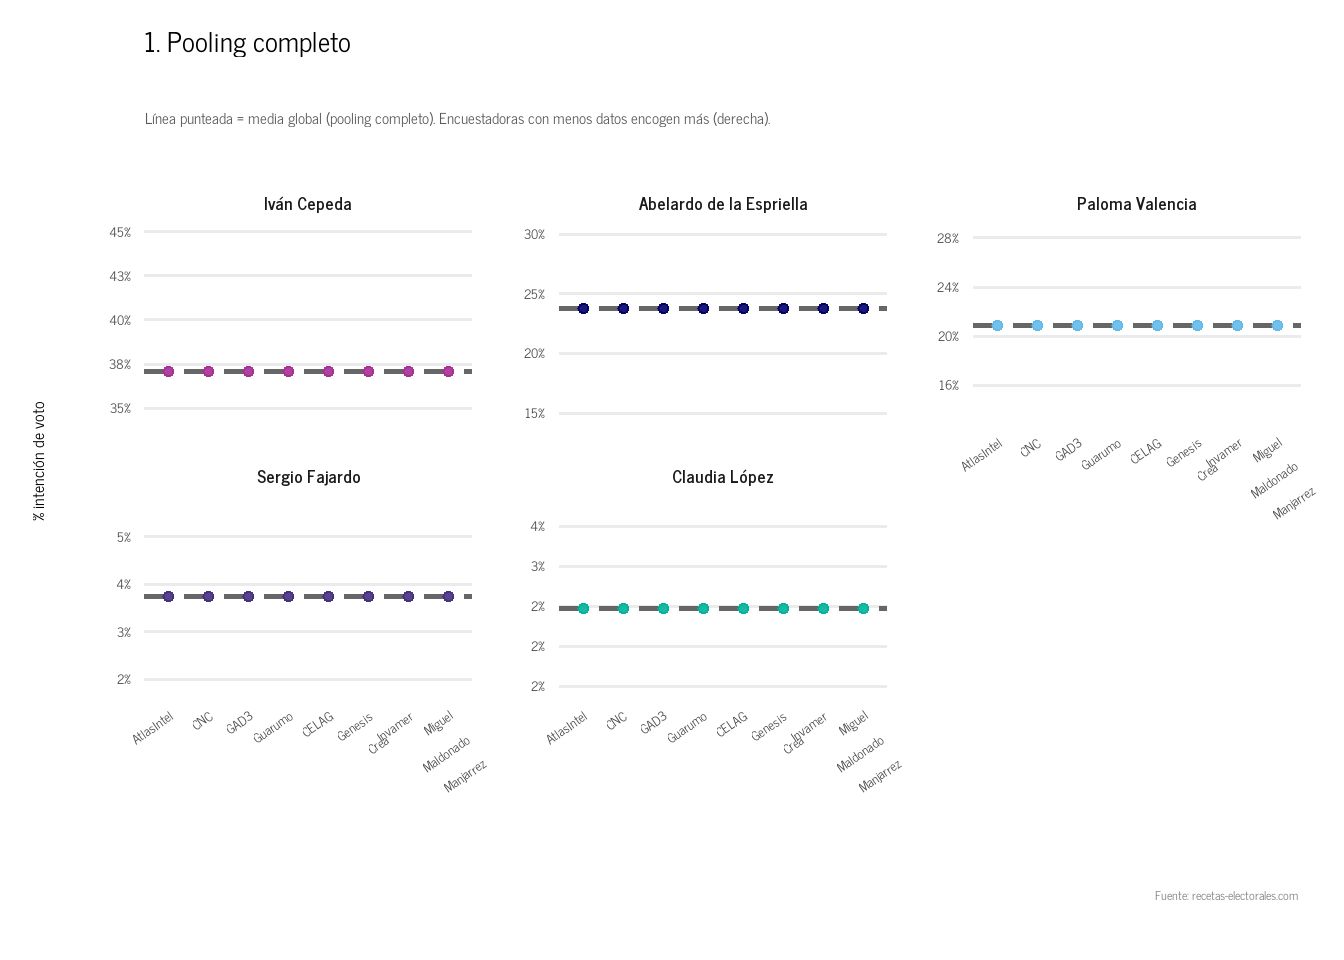
La característica más poderosa del modelo multinivel es el shrinkage: cada encuestadora es un punto en el espacio de estimaciones y el modelo las “jala” hacia el centro según cuánta evidencia tiene. La animación Figura 5 muestra cómo se mueve cada casa encuestadora entre tres escenarios:
Pooling completo: Todas colapsan al mismo punto, el promedio global.
Sin pooling: Cada encuestadora se estimada de forma independiente.
Partial pooling (Cazuela): El modelo jerárquico regula —las encuestadoras con pocas encuestas se encogen más hacia el centro que las que tienen varias muestras.
Figura 5: Pooling en la Cazuela
Correlación entre efectos de casa
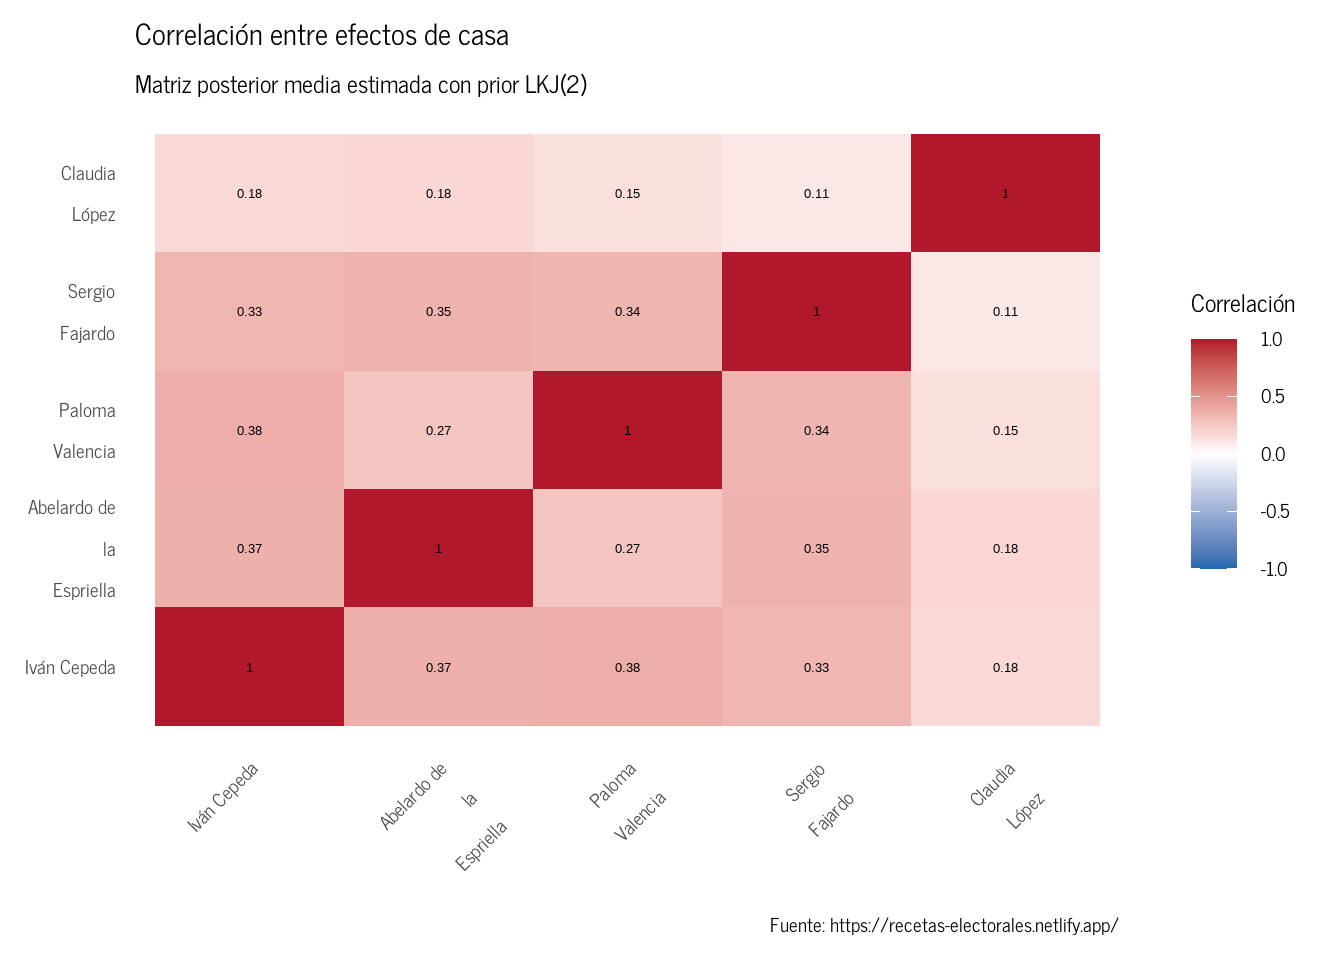
El modelo estima explícitamente la matriz de correlación \(\Omega\) entre los efectos de casa de los candidatos usando un prior LKJ. Esto captura si las encuestadoras que sobreestiman a un candidato tienden a subestimar a otro Figura 6.
Extraemos los parámetros Omega[i,j] (matriz de correlación) del posterior, decodificamos los índices y promediamos cada celda, uniendo los nombres de candidato.
2
Reordenamos las filas/columnas según el orden global de candidatos.
3
Construimos el mapa de calor (candidato × candidato) con la correlación como relleno y su valor como texto.
4
Escala divergente azul-blanco-rojo centrada en cero, de −1 a 1.
5
Títulos y nota de fuente.
6
Tema minimalista con tipografía de marca y etiquetas del eje X rotadas.
Figura 6: Matriz de correlación posterior de efectos de casa
Diagnósticos
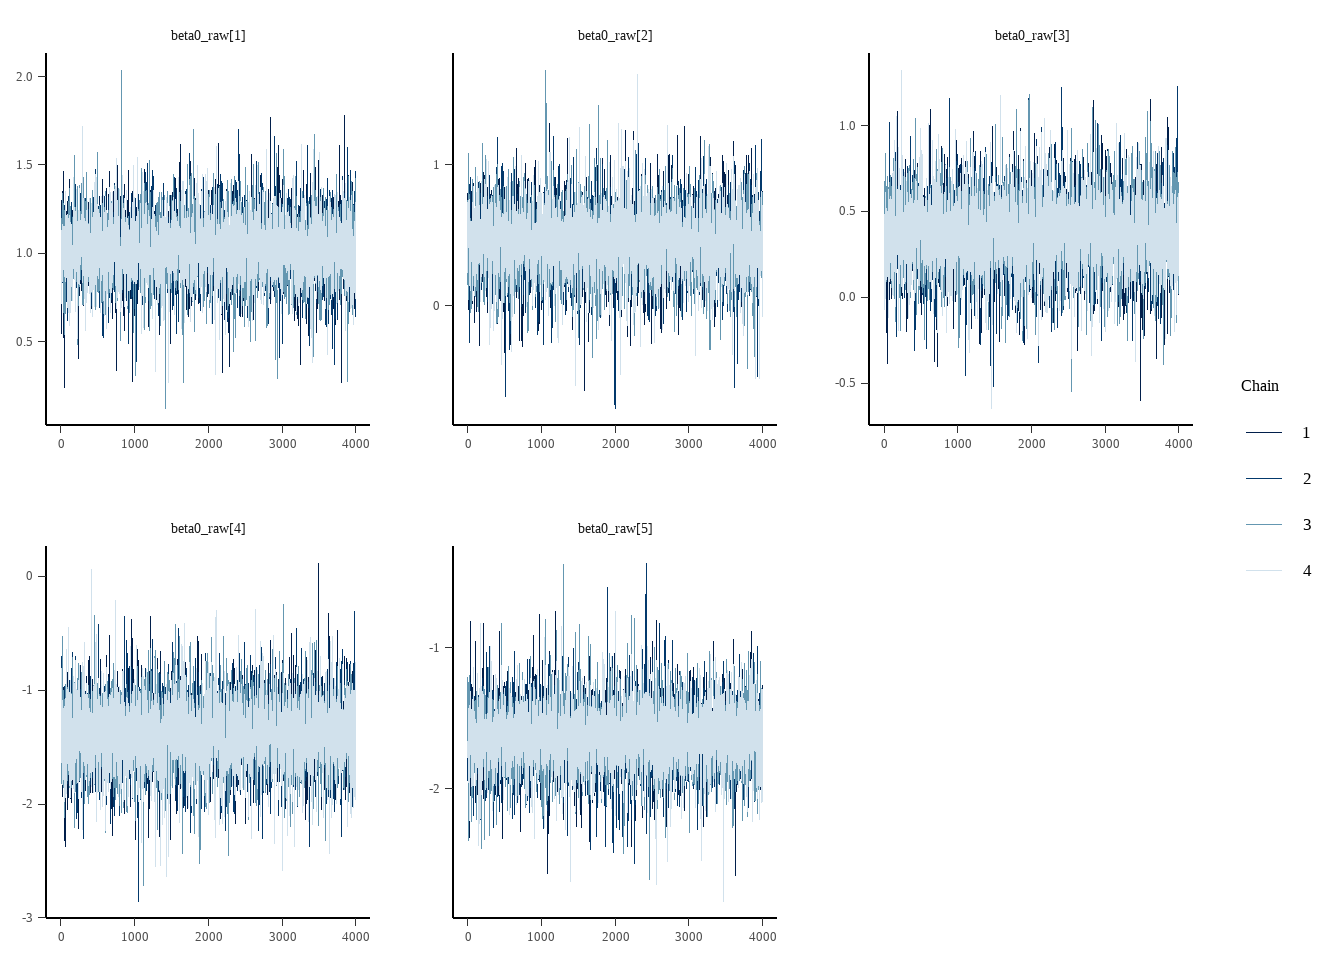
El muestreo MCMC:
Ver código
bayesplot::mcmc_trace(cazuela_fit$draws(), pars = ggplot2::vars(matches("beta0_raw")))
1
Traceplots de las cadenas MCMC para los interceptos beta0_raw: si las cadenas se mezclan bien, el muestreo convergió.
Receta Cazuela
La Cazuela extiende el Ajiaco2 al permitir que las proporciones de candidatos varíen por encuesta como función de covariables. En lugar de un solo vector \(\mathbf{p}\) pooled, cada encuesta \(j\) tiene su propio \(\mathbf{p}_j\) construido a partir de un predictor lineal con función de enlace softmax, como en un GLM multinomial.
La novedad clave es que los efectos de casa se modelan como efectos aleatorios multinivel con una estructura de covarianza completa. Los vectores \(\boldsymbol{\delta}_h\) se extraen de una distribución normal multivariada cuya matriz de covarianza se descompone en desviaciones estándar por candidato (\(\boldsymbol{\sigma}_\delta\)) y una matriz de correlación (\(\Omega\)) con prior LKJ. Se usa la parametrización no-centrada (\(\boldsymbol{\delta}_h = \mathrm{diag}(\boldsymbol{\sigma}_\delta) \cdot L_\Omega \cdot \mathbf{z}_h\)) para mejorar la eficiencia del muestreo MCMC:
Donde \(t_j\) es el tiempo centrado y escalado de la encuesta \(j\), \(h_j\) es el índice de la encuestadora, y \(L_\Omega\) es el factor Cholesky de la matriz de correlación \(\Omega\). El prior \(\mathrm{LKJ}(2)\) favorece correlaciones moderadas, lo que actúa como regularización contra matrices de correlación extremas.
Tabla resumen posterior de los efectos fijos (beta0_raw, beta_time_raw) y la concentración kappa, con intervalos y diagnósticos de convergencia (rhat, ess).
La Cazuela modelaba tendencias temporales y efectos de casa encuestadora. En las últimas encuestas el coeficiente de tendencia de ADLE era positivo — la señal estaba ahí — pero la extrapolación al 31 de mayo no alcanzó el resultado final de 43.72%. Para la evaluación completa de precisión ver Café.
Cómo citar
BibTeX
@online{recetas_electorales2026,
  author = {{Recetas Electorales}},
  title = {🍲 Cazuela},
  date = {2026-04-13},
  url = {https://recetas-electorales.netlify.app/elecciones/2026-colombia/2026-04-13-cazuela/2026-cazuela.html},
  langid = {es}
}