🌊 Gaussiano

encuestas
gaussian process
cmdstanr
lkj

Modelando las tendencias de todos los candidatos simultáneamente.

Autor/a
Afiliación

Recetas Electorales

Análisis independiente

Fecha de publicación

16 de mayo de 2026

Fecha de última modificación

13 de junio de 2026

“A Gaussian process is a distribution over functions.”
—Rasmussen & Williams

Introduciendo el Gaussiano

La Cazuela estimó tendencias con una regresión: para cada candidato, un intercepto y una pendiente en el tiempo. Eso captura dirección pero no forma: si un candidato primero cae y luego repunta, o si el cambio se acelera en las últimas semanas, la línea recta lo pierde.

El Gaussiano reemplaza esa línea recta con un Gaussian Process (GP): una distribución sobre funciones suaves que aprende la forma de la tendencia directamente de los datos. Curvatura, aceleración, rebotes —todo queda capturado.

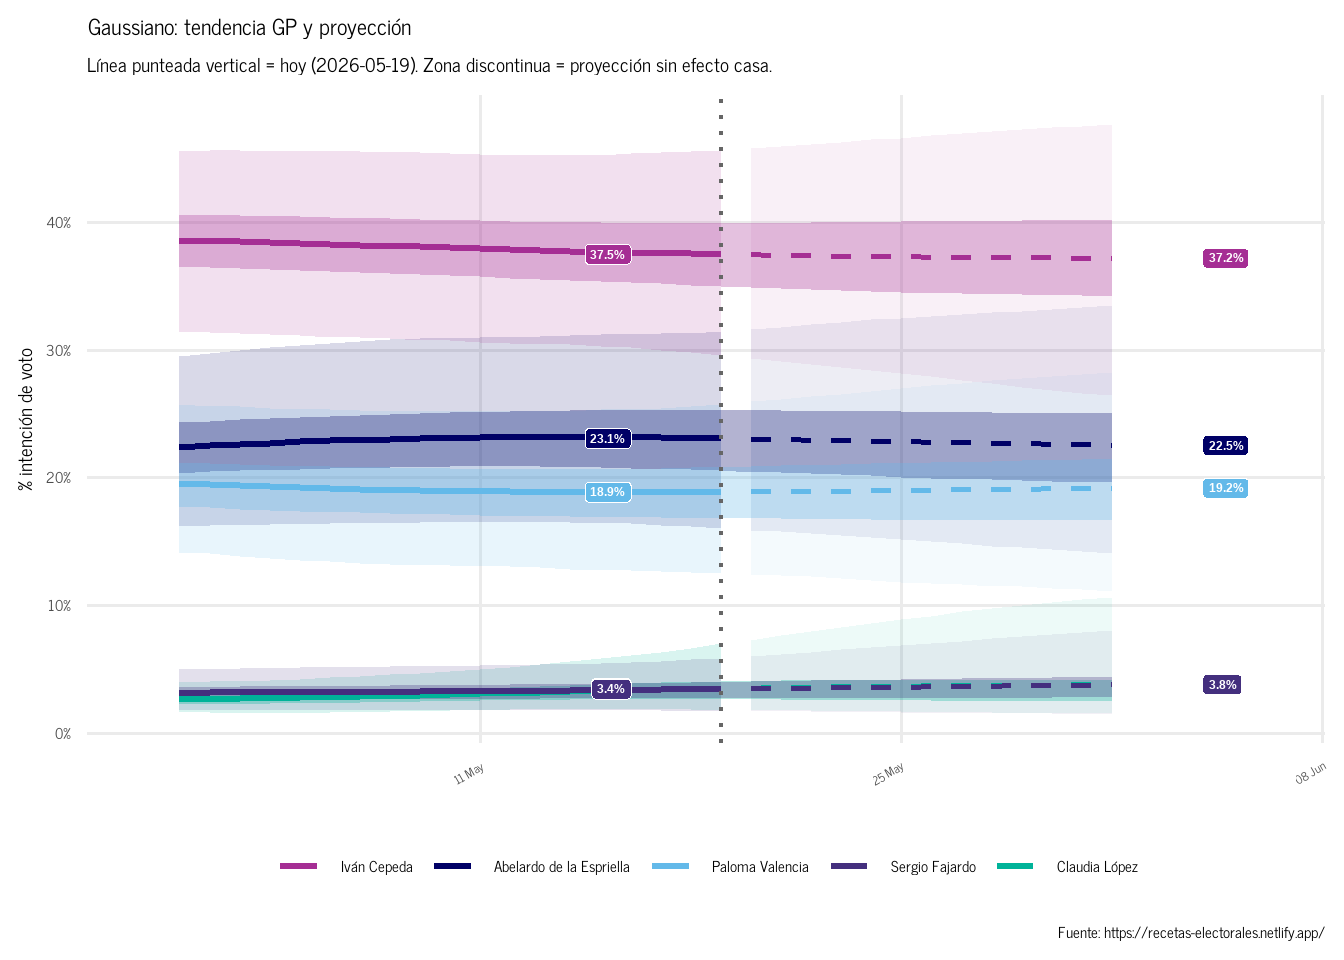
Pero la innovación más importante es otra: los GPs de los candidatos están correlacionados. Si Claudia López gana terreno, ¿a quién le quita votos? ¿A Paloma Valencia? ¿A Fajardo? El modelo estima una matriz de correlación entre las trayectorias de todos los candidatos, revelando la dinámica competitiva de la carrera.

La ventaja del GP es visible en la siguiente gráfica Figura 1: las curvas ya no son líneas rectas. La región sombreada corresponde a la proyección hacia el futuro (sin efecto casa), donde la incertidumbre crece a medida que nos alejamos de los datos observados —comportamiento propio de un GP bien calibrado.

Ver código
fecha_hoy <- Sys.Date()

p_pred_summary <- purrr::map_dfr(seq_len(J_pred), function(j2) {
  cols_j <- paste0("p_pred[", j2, ",", seq_len(K), "]")
  draws_all |>
    dplyr::select(dplyr::all_of(cols_j)) |>
    purrr::set_names(cand_names) |>
    tidyr::pivot_longer(dplyr::everything(), names_to = "candidato", values_to = "prop") |>
    dplyr::group_by(candidato) |>
    dplyr::summarise(
      media = mean(prop),
      q025  = quantile(prop, 0.025),
      q975  = quantile(prop, 0.975),
      q25   = quantile(prop, 0.25),
      q75   = quantile(prop, 0.75),
      .groups = "drop"
    ) |>
    dplyr::mutate(fecha = fecha_pred_seq[[j2]])
}) |>
  dplyr::mutate(cod = stringr::str_sub(candidato, start = 6L)) |>
  dplyr::left_join(candidatos_2026, by = "cod") |>
  dplyr::filter(cod != "ruido")

orden_candidatos <- p_pred_summary |>
  dplyr::group_by(nombre) |>
  dplyr::summarise(media_global = mean(media), .groups = "drop") |>
  dplyr::arrange(dplyr::desc(media_global)) |>
  dplyr::pull(nombre)

fecha_inicio <- lubridate::ymd("2026-05-01")

datos_plot <- p_pred_summary |>
  dplyr::filter(fecha >= fecha_inicio) |>
  dplyr::mutate(
    nombre    = factor(nombre, levels = orden_candidatos),
    es_futuro = fecha > fecha_hoy
  )

colores_leyenda <- datos_plot |>
  dplyr::distinct(nombre, color_cand) |>
  dplyr::arrange(match(nombre, orden_candidatos))

etiquetas_hoy <- datos_plot |>
  dplyr::filter(!es_futuro) |>
  dplyr::group_by(nombre, color_cand) |>
  dplyr::filter(fecha == max(fecha)) |>
  dplyr::ungroup() |>
  dplyr::mutate(apellido = stringr::word(nombre, -1))

etiquetas_pred <- datos_plot |>
  dplyr::group_by(nombre, color_cand) |>
  dplyr::filter(fecha == max(fecha)) |>
  dplyr::ungroup() |>
  dplyr::mutate(apellido = stringr::word(nombre, -1))

datos_plot |>
  ggplot2::ggplot(ggplot2::aes(x = fecha, color = color_cand, fill = color_cand)) +
  ggplot2::geom_ribbon(
    ggplot2::aes(ymin = q025, ymax = q975, alpha = es_futuro),
    color = NA
  ) +
  ggplot2::geom_ribbon(
    ggplot2::aes(ymin = q25, ymax = q75),
    alpha = 0.30, color = NA
  ) +
  ggplot2::geom_line(
    data = ~ dplyr::filter(.x, !es_futuro),
    ggplot2::aes(y = media), linewidth = 1.1
  ) +
  ggplot2::geom_line(
    data = ~ dplyr::filter(.x, es_futuro),
    ggplot2::aes(y = media), linewidth = 1.0, linetype = "dashed"
  ) +
  ggplot2::geom_vline(
    xintercept = as.numeric(fecha_hoy),
    linetype = "dotted", color = "gray40", linewidth = 0.8
  ) +
  ggplot2::geom_label(
    data          = etiquetas_hoy,
    ggplot2::aes(y = media,
                 label = paste0(apellido, "\n", scales::percent(media, accuracy = 0.1)),
                 fill = color_cand),
    nudge_x       = -3,
    hjust         = 1,
    color         = "white",
    fontface      = "bold",
    size          = 3.2,
    lineheight    = 0.9,
    label.padding = ggplot2::unit(0.2, "lines"),
    show.legend   = FALSE
  ) +
  ggplot2::geom_label(
    data          = etiquetas_pred,
    ggplot2::aes(y = media,
                 label = paste0(apellido, "\n", scales::percent(media, accuracy = 0.1)),
                 fill = color_cand),
    nudge_x       = 3,
    hjust         = 0,
    color         = "white",
    fontface      = "bold",
    size          = 3.2,
    lineheight    = 0.9,
    label.padding = ggplot2::unit(0.2, "lines"),
    show.legend   = FALSE
  ) +
  ggplot2::geom_point(
    data = tibble::tribble(
      ~color_cand,             ~resultado,
      colores_2026[["ic"]],   0.4092,
      colores_2026[["adle"]], 0.4372,
      colores_2026[["pv"]],   0.0692,
      colores_2026[["sf"]],   0.0426,
      colores_2026[["cl"]],   0.0095
    ) |> dplyr::mutate(fecha = lubridate::ymd("2026-05-31")),
    ggplot2::aes(x = fecha, y = resultado, color = color_cand),
    shape = 18, size = 6, inherit.aes = FALSE
  ) +
  ggplot2::geom_label(
    data = tibble::tribble(
      ~color_cand,             ~resultado,
      colores_2026[["ic"]],   0.4092,
      colores_2026[["adle"]], 0.4372,
      colores_2026[["pv"]],   0.0692,
      colores_2026[["sf"]],   0.0426,
      colores_2026[["cl"]],   0.0095
    ) |> dplyr::mutate(fecha = lubridate::ymd("2026-05-31")),
    ggplot2::aes(
      x     = fecha,
      y     = resultado,
      label = scales::percent(resultado, accuracy = 0.1),
      fill  = color_cand
    ),
    hjust         = -0.15,
    color         = "white",
    size          = 3,
    fontface      = "bold",
    label.size    = 0,
    label.padding = ggplot2::unit(0.2, "lines"),
    inherit.aes   = FALSE
  ) +
  ggplot2::scale_color_identity(guide = "none") +
  ggplot2::scale_fill_identity() +
  ggplot2::scale_alpha_manual(
    values = c(`FALSE` = 0.15, `TRUE` = 0.07),
    guide  = "none"
  ) +
  ggplot2::scale_y_continuous(labels = scales::percent_format(accuracy = 1)) +
  ggplot2::scale_x_date(
    date_labels = "%d %b",
    date_breaks = "2 weeks",
    expand      = ggplot2::expansion(mult = c(0.09, 0.12))
  ) +
  ggplot2::labs(
    title    = "Gaussiano: tendencia GP y proyección",
    subtitle = paste0("Línea punteada vertical = hoy (", fecha_hoy,
                      "). Zona discontinua = proyección sin efecto casa."),
    caption  = "Fuente: https://recetas-electorales.netlify.app/",
    x        = NULL,
    y        = "% intención de voto"
  ) +
  ggplot2::theme_minimal(base_size = 14) +
  ggplot2::theme(
    text             = ggplot2::element_text(family = "news-cycle"),
    panel.grid.minor = ggplot2::element_blank(),
    strip.text       = ggplot2::element_text(face = "bold", size = 13),
    axis.text.x      = ggplot2::element_text(angle = 30, hjust = 1, size = 9),
    legend.position  = "none"
  )
1
Fijamos la fecha de hoy para separar pasado y proyección.
2
Para cada punto de la grilla de predicción, resumimos el posterior de p_pred[j,k] (media e intervalos creíbles) por candidato.
3
Definimos el orden global de candidatos por su media posterior.
4
Filtramos desde el 1° de mayo y marcamos qué puntos son proyección futura (es_futuro).
5
Construimos los conjuntos de etiquetas para “hoy” y para el final de la proyección.
6
Gráfico base (fecha en X, color por candidato).
7
Bandas de incertidumbre: intervalo creíble del 95% y del 50%, con menor opacidad en la zona futura.
8
Líneas de tendencia: sólida en el pasado, punteada en la proyección, más la vertical de “hoy”.
9
Etiquetas de cada candidato al inicio (hoy) y al final (proyección).
10
Diamantes con el resultado real de la primera vuelta (31 de mayo).
11
Escalas: colores de marca, opacidad pasado/futuro, eje X de fechas.
12
Títulos, subtítulo (fecha de hoy) y nota de fuente.
13
Tema minimalista con tipografía de marca y fechas rotadas.
Figura 1: Tendencia GP por candidato: pasado y proyección a futuro

Evolución acumulada

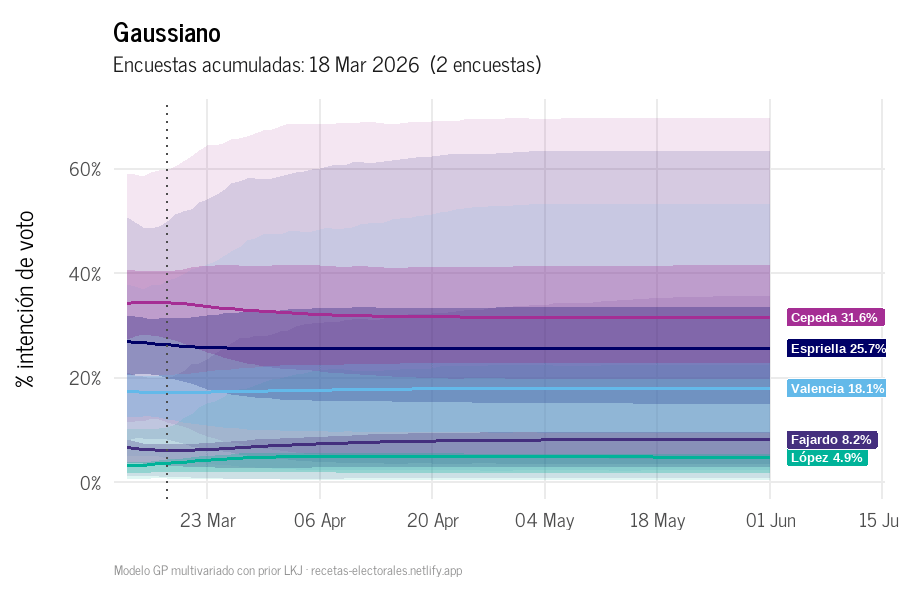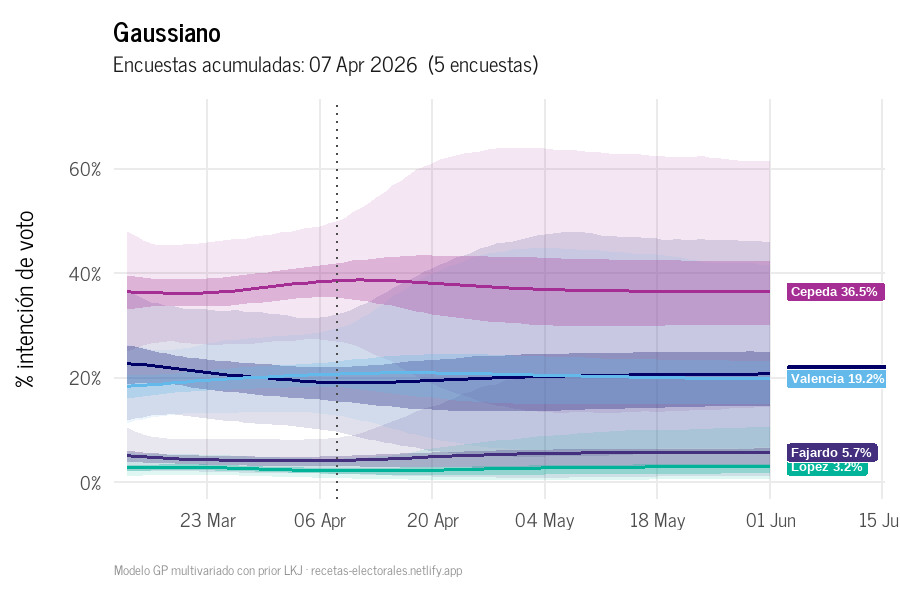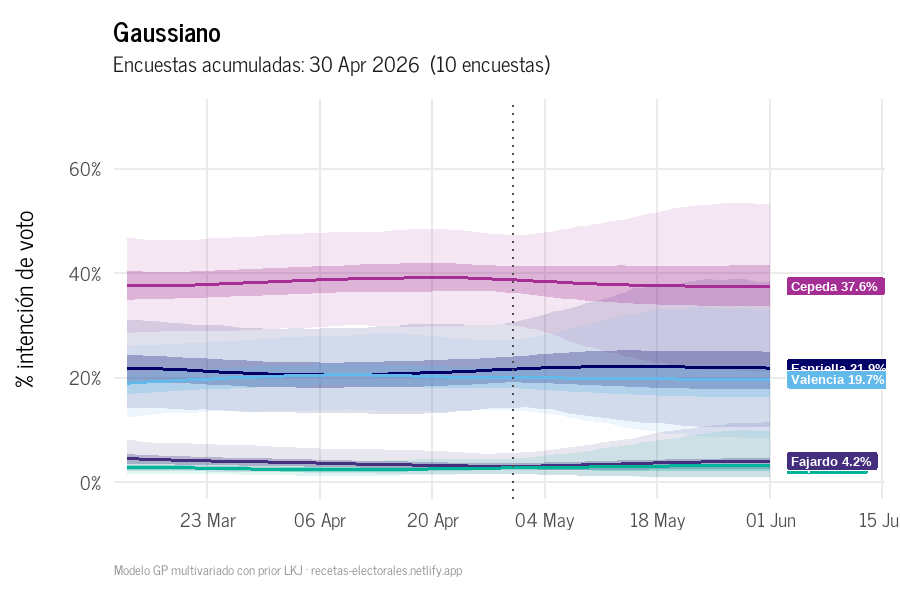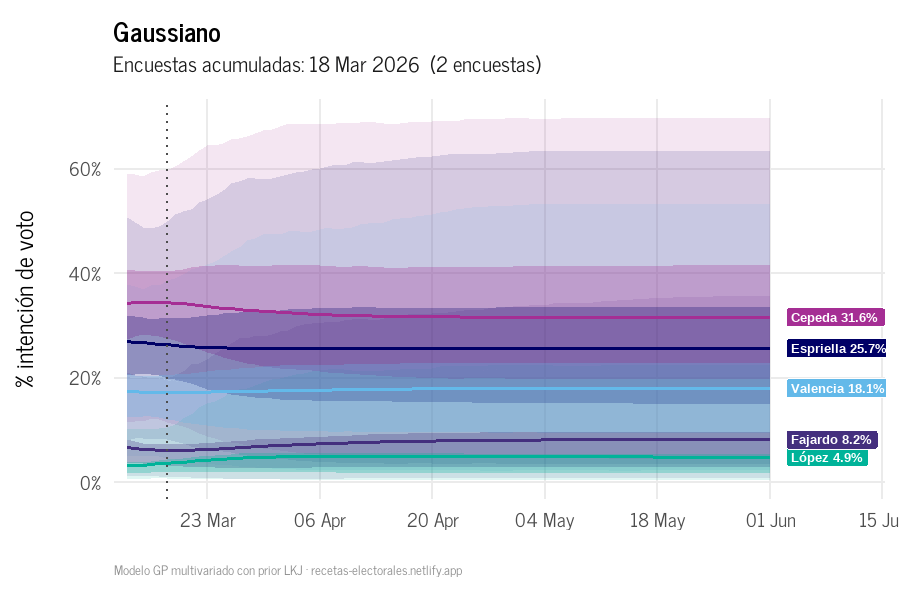
La animación muestra cómo el GP actualiza las trayectorias a medida que se incorporan nuevas encuestas, con la proyección al 1° de junio.

Gaussiano: evolución acumulada de trayectorias GP

Gaussiano: evolución acumulada de trayectorias GP

Valencia vs. De la Espriella: Proyecciones

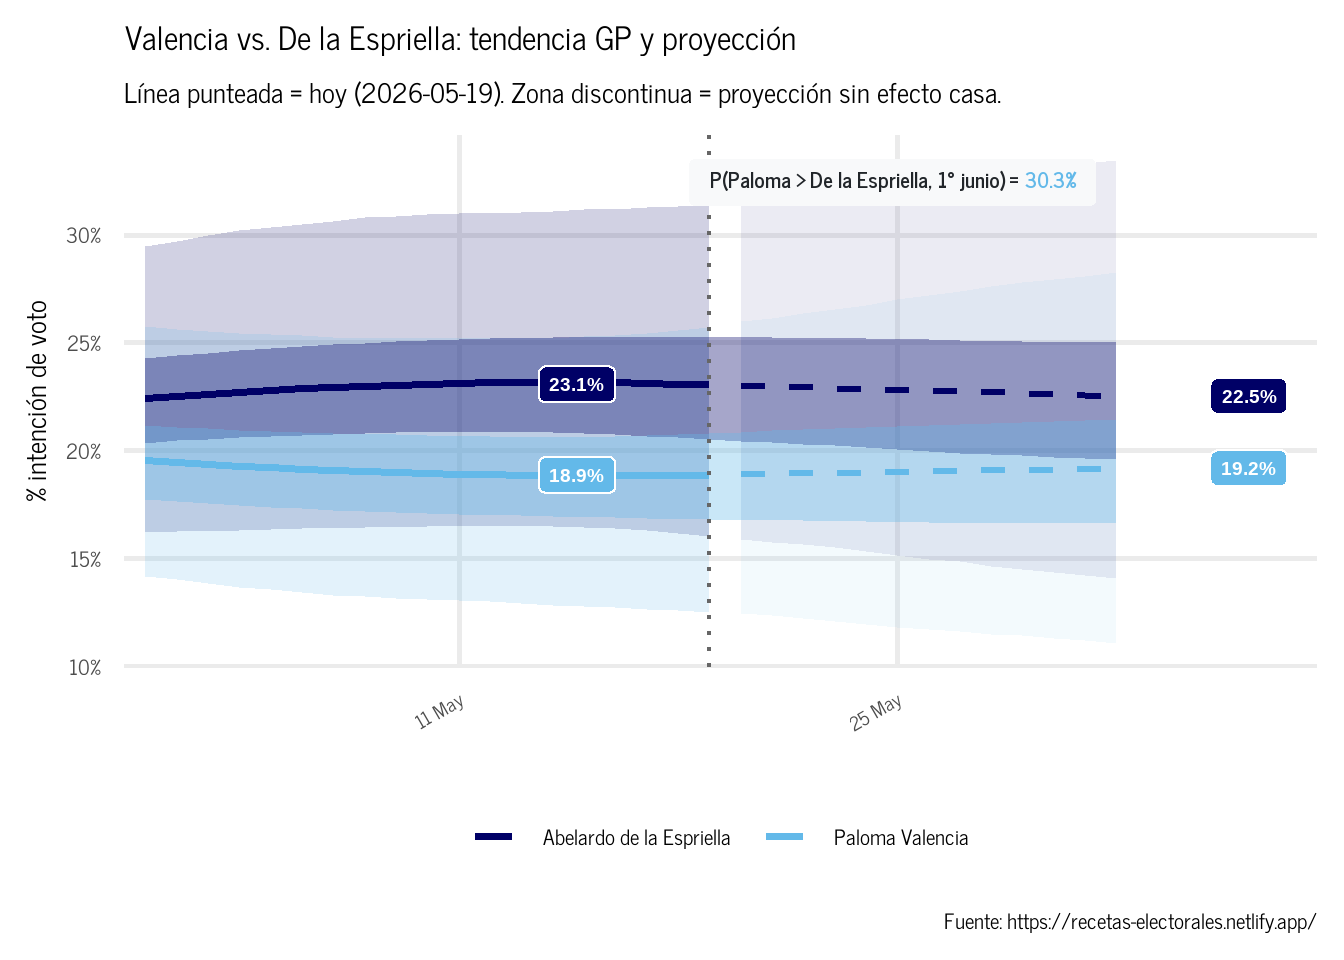
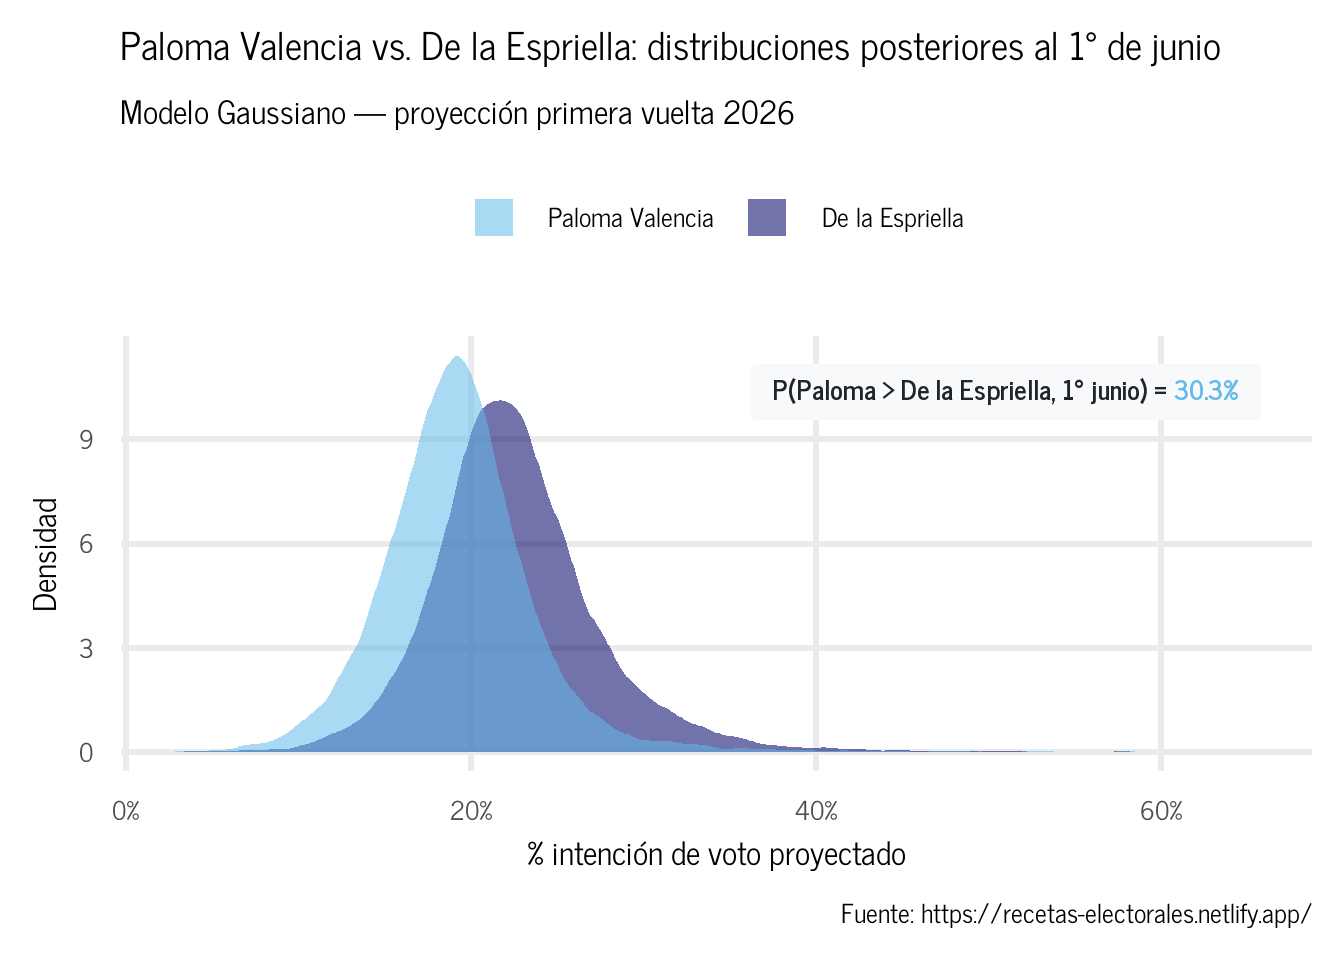
Paloma Valencia y Abelardo de la Espriella compiten por el mismo electorado de derecha. El GP permite ver si sus trayectorias se cruzan —o si una de las dos consolida la ventaja de cara al 1° de junio.

Ver código
library(ggtext)

k_pv   <- which(cand_names == "cand_pv")
k_adle <- which(cand_names == "cand_adle")
prob_pv_gt_adle_gp <- mean(
  draws_all[[paste0("p_pred[", J_pred, ",", k_pv,   "]")]] >
  draws_all[[paste0("p_pred[", J_pred, ",", k_adle, "]")]]
)

duo_plot <- p_pred_summary |>
  dplyr::filter(
    cod %in% c("pv", "adle"),
    fecha >= lubridate::ymd("2026-05-01")
  ) |>
  dplyr::mutate(es_futuro = fecha > fecha_hoy)

duo_etiquetas_hoy <- duo_plot |>
  dplyr::filter(!es_futuro) |>
  dplyr::group_by(nombre, color_cand) |>
  dplyr::filter(fecha == max(fecha)) |>
  dplyr::ungroup() |>
  dplyr::mutate(apellido = stringr::word(nombre, -1))

duo_etiquetas_pred <- duo_plot |>
  dplyr::group_by(nombre, color_cand) |>
  dplyr::filter(fecha == max(fecha)) |>
  dplyr::ungroup() |>
  dplyr::mutate(apellido = stringr::word(nombre, -1))

.meses_es <- c("enero","febrero","marzo","abril","mayo","junio",
               "julio","agosto","septiembre","octubre","noviembre","diciembre")
.f <- max(encuestas_2026$fecha)
fecha_ultima_encuesta <- paste(
  lubridate::day(.f), "de",
  .meses_es[lubridate::month(.f)], "de",
  lubridate::year(.f)
)

duo_plot |>
  ggplot2::ggplot(ggplot2::aes(x = fecha, color = color_cand, fill = color_cand)) +
  ggplot2::geom_ribbon(
    ggplot2::aes(ymin = q025, ymax = q975, alpha = es_futuro),
    color = NA
  ) +
  ggplot2::geom_ribbon(
    ggplot2::aes(ymin = q25, ymax = q75),
    alpha = 0.35, color = NA
  ) +
  ggplot2::geom_line(
    data = ~ dplyr::filter(.x, !es_futuro),
    ggplot2::aes(y = media), linewidth = 1.3
  ) +
  ggplot2::geom_line(
    data = ~ dplyr::filter(.x, es_futuro),
    ggplot2::aes(y = media), linewidth = 1.2, linetype = "dashed"
  ) +
  ggplot2::geom_vline(
    xintercept = as.numeric(fecha_hoy),
    linetype = "dotted", color = "gray40", linewidth = 0.8
  ) +
  ggplot2::geom_label(
    data          = duo_etiquetas_hoy,
    ggplot2::aes(y = media,
                 label = paste0(apellido, "\n", scales::percent(media, accuracy = 0.1)),
                 fill = color_cand),
    nudge_x       = -3,
    hjust         = 1,
    color         = "white",
    fontface      = "bold",
    size          = 4.5,
    lineheight    = 0.9,
    label.padding = ggplot2::unit(0.25, "lines"),
    show.legend   = FALSE
  ) +
  ggplot2::geom_label(
    data          = duo_etiquetas_pred,
    ggplot2::aes(y = media,
                 label = paste0(apellido, "\n", scales::percent(media, accuracy = 0.1)),
                 fill = color_cand),
    nudge_x       = 3,
    hjust         = 0,
    color         = "white",
    fontface      = "bold",
    size          = 4.5,
    lineheight    = 0.9,
    label.padding = ggplot2::unit(0.25, "lines"),
    show.legend   = FALSE
  ) +
  ggtext::geom_richtext(
    data = tibble::tibble(x = max(duo_plot$fecha), y = Inf),
    ggplot2::aes(
      x = x, y = y,
      label = sprintf(
        "<b>P(Paloma > De la Espriella, 1° junio) = <span style='color:#63B9E9'>%.1f%%</span></b>",
        prob_pv_gt_adle_gp * 100
      )
    ),
    inherit.aes  = FALSE,
    hjust        = 1.05,
    vjust        = 1.5,
    size         = 5.5,
    family       = "news-cycle",
    fill         = "#F8F9FA",
    color        = "#212529",
    label.color  = NA,
    label.padding = ggplot2::unit(c(0.35, 0.55, 0.35, 0.55), "lines")
  ) +
  ggplot2::scale_color_identity(guide = "none") +
  ggplot2::scale_fill_identity() +
  ggplot2::scale_alpha_manual(values = c(`FALSE` = 0.18, `TRUE` = 0.08),
                               guide = "none") +
  ggplot2::scale_y_continuous(labels = scales::percent_format(accuracy = 1)) +
  ggplot2::scale_x_date(
    date_labels = "%d %b",
    date_breaks = "2 weeks",
    expand      = ggplot2::expansion(mult = c(0.09, 0.14))
  ) +
  ggplot2::labs(
    title    = "Valencia vs. De la Espriella: tendencia GP y proyección",
    subtitle = paste0("Línea punteada = hoy (", fecha_hoy,
                      "). Zona discontinua = proyección sin efecto casa."),
    caption  = "Fuente: https://recetas-electorales.netlify.app/",
    x        = NULL,
    y        = "% intención de voto"
  ) +
  ggplot2::theme_minimal(base_size = 20) +
  ggplot2::theme(
    text             = ggplot2::element_text(family = "news-cycle"),
    panel.grid.minor = ggplot2::element_blank(),
    axis.text.x      = ggplot2::element_text(angle = 30, hjust = 1, size = 14),
    legend.position  = "none"
  )
1
Localizamos los índices de Paloma Valencia y De la Espriella y calculamos la probabilidad posterior P(Paloma > De la Espriella) en la proyección al 1° de junio.
2
Filtramos la trayectoria de ambos candidatos desde el 1° de mayo.
3
Construimos los conjuntos de etiquetas para “hoy” y para el final de la proyección.
4
Formateamos la fecha de la última encuesta para el subtítulo.
5
Gráfico base (fecha en X, color por candidato).
6
Bandas de incertidumbre: intervalo creíble del 95% y del 50%.
7
Líneas de tendencia (sólida pasado, punteada proyección) y la vertical de “hoy”.
8
Etiquetas de cada candidato al inicio y al final.
9
Anotación enriquecida con la probabilidad P(Paloma > De la Espriella).
10
Escalas: colores de marca, opacidad pasado/futuro y eje X de fechas.
11
Títulos, subtítulo y nota de fuente.
12
Tema minimalista con tipografía de marca y fechas rotadas.
Figura 2: Trayectoria GP y proyección: Paloma Valencia y Abelardo de la Espriella
Ver código
library(ggtext)

draws_duo <- tibble::tibble(
  p_pv   = draws_all[[paste0("p_pred[", J_pred, ",", k_pv,   "]")]],
  p_adle = draws_all[[paste0("p_pred[", J_pred, ",", k_adle, "]")]]
) |>
  tidyr::pivot_longer(
    cols      = c(p_pv, p_adle),
    names_to  = "candidato",
    values_to = "prop"
  ) |>
  dplyr::mutate(
    color_cand = dplyr::case_when(
      candidato == "p_pv"   ~ "#63B9E9",
      candidato == "p_adle" ~ "#000066"
    )
  )

draws_duo |>
  ggplot2::ggplot(ggplot2::aes(x = prop, fill = color_cand)) +
  ggplot2::geom_density(alpha = 0.55, color = NA) +
  ggplot2::scale_x_continuous(labels = scales::percent_format(accuracy = 1)) +
  ggplot2::scale_fill_identity(
    guide  = "legend",
    labels = c("#63B9E9" = "Paloma Valencia", "#000066" = "De la Espriella"),
    breaks = c("#63B9E9", "#000066")
  ) +
  ggtext::geom_richtext(
    data = tibble::tibble(x = Inf, y = Inf),
    ggplot2::aes(
      x = x, y = y,
      label = sprintf(
        "<b>P(Paloma > De la Espriella, 1° junio) = <span style='color:#63B9E9'>%.1f%%</span></b>",
        prob_pv_gt_adle_gp * 100
      )
    ),
    inherit.aes   = FALSE,
    hjust         = 1.1,
    vjust         = 1.5,
    size          = 7,
    family        = "news-cycle",
    fill          = "#F8F9FA",
    color         = "#212529",
    label.color   = NA,
    label.padding = ggplot2::unit(c(0.4, 0.6, 0.4, 0.6), "lines")
  ) +
  ggplot2::labs(
    title    = "Paloma Valencia vs. De la Espriella: distribuciones posteriores al 1° de junio",
    subtitle = paste0("Modelo Gaussiano estimado el ", fecha_ultima_encuesta,
                      " con ", dplyr::n_distinct(encuestas_2026$encuesta_id), " encuestas"),
    x        = "% intención de voto proyectado",
    y        = "Densidad",
    fill     = NULL,
    caption  = "Fuente: https://recetas-electorales.netlify.app/"
  ) +
  ggplot2::theme_minimal(base_size = 24) +
  ggplot2::theme(
    text             = ggplot2::element_text(family = "news-cycle"),
    panel.grid.minor = ggplot2::element_blank(),
    legend.position  = "top"
  )
1
Construimos un tibble con las muestras posteriores proyectadas de Paloma Valencia y De la Espriella, en formato largo y con su color de marca.
2
Gráfico base con la densidad posterior de cada candidato.
3
Eje X en porcentaje y leyenda con los nombres por color.
4
Anotación enriquecida con la probabilidad P(Paloma > De la Espriella) al 1° de junio.
5
Títulos, subtítulo (fecha y número de encuestas) y nota de fuente.
6
Tema minimalista con tipografía de marca y leyenda arriba.
Figura 3: Distribuciones posteriores de Paloma Valencia y De la Espriella al 1° de junio (Gaussiano)

Diagnósticos

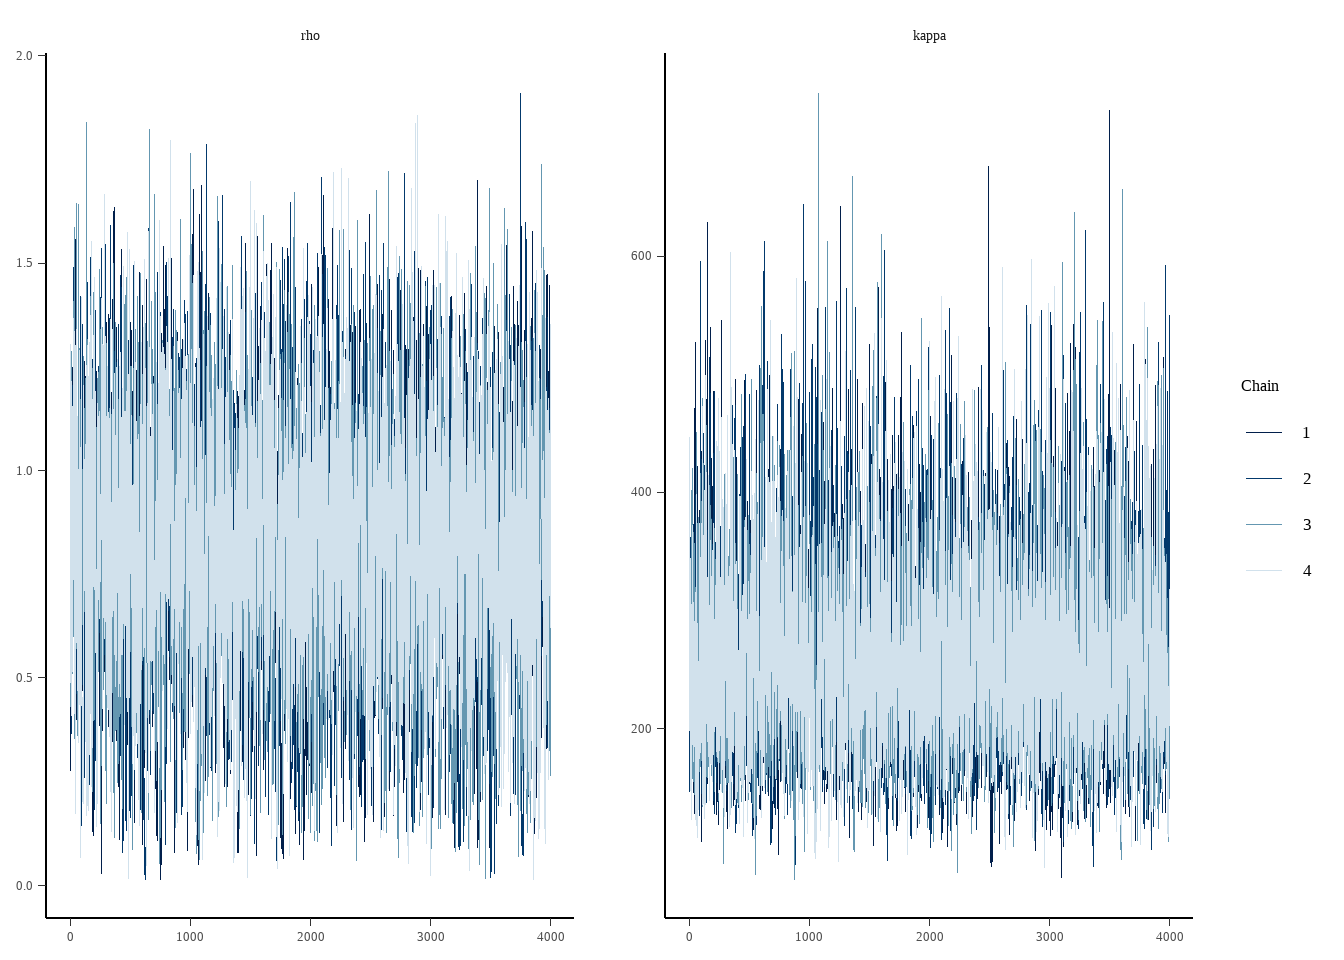
Escala de longitud del GP (\(\rho\)) y parámetros de concentración:

Ver código
library(bayesplot)

draws_diag <- draws_all |>
  dplyr::select(.chain, .iteration, .draw, rho, kappa) |>
  posterior::as_draws_array()

bayesplot::mcmc_trace(draws_diag, regex_pars = "^rho$|^kappa$")
1
Seleccionamos del posterior los parámetros globales rho (escala de longitud del GP) y kappa (concentración) en formato de arreglo de cadenas.
2
Traceplots de rho y kappa: diagnostican la convergencia del muestreo MCMC.

El Gaussiano viene con ñapa para explorar interactivamente el modelo de Proceso Gaussiano. Selecciona un candidato y un umbral de intención de voto para ver las tendencias y las probabilidades posteriores al 25 de mayo.

Receta Gaussiano

El Gaussiano reemplaza la regresión de Ajiaco2 y Cazuela con un Gaussian Process multivariado correlacionado, que es simultáneamente:

  1. Suavizante: la tendencia de cada candidato puede tener cualquier forma suave —no solo una línea recta.
  2. Predictivo: la estructura GP permite extrapolar con incertidumbre creciente hacia el futuro.
  3. Correlacionado: la covarianza entre los GPs de diferentes candidatos captura la dinámica competitiva de la carrera.

\[ \begin{aligned} &\textbf{GP multivariado (coregionalización lineal):}\\ &f_k(t) \sim \mathcal{GP}(0,\; \alpha_k^2\, k_\rho(t, t')), \quad k=1,\dots,K-1,\\ &\mathrm{Cov}(f_k(t),\, f_l(t')) = \alpha_k\,\alpha_l\;\Omega_{GP}[k,l]\;k_\rho(t,t'),\\[6pt] &\textbf{Kernel Squared-Exponential:}\\ &k_\rho(t,t') = \exp\!\left(-\frac{(t-t')^2}{2\rho^2}\right).\\[6pt] &\textbf{Predictor lineal:}\\ &\eta_{jk} = \mu_k + f_k(t_j) + \delta_{k,h_j}, \quad k=1,\dots,K-1,\\ &\eta_{jK} = 0 \quad \text{(referencia)}.\\[6pt] &\textbf{Parametrización no-centrada del GP:}\\ &f_k = \alpha_k\,\bigl(L_{\Omega_{GP}}\,\mathbf{z}_{GP}\bigr)_k \cdot L_t^{\top},\\ &\mathbf{z}_{GP} \sim \mathrm{Normal}_{(K-1)\times J}(0, I), \quad L_t = \mathrm{chol}(K_t).\\[6pt] &\textbf{Efectos de casa (multinivel):}\\ &\boldsymbol{\delta}_h = \mathrm{diag}(\boldsymbol{\sigma}_\delta)\,L_{\Omega_\delta}\,\mathbf{z}_h, \quad \mathbf{z}_h \sim \mathrm{Normal}_{K-1}(\mathbf{0}, I).\\[6pt] &\textbf{Priors:}\\ &\mu_k \sim \mathrm{Normal}(0, 2),\\ &\rho \sim \mathrm{Normal}^+(0.5,\;0.3),\\ &\alpha_{GP,k} \sim \mathrm{Normal}^+(0, 1),\\ &L_{\Omega_{GP}},\;L_{\Omega_\delta} \sim \mathrm{LKJ\_cholesky}(2),\\ &\sigma_{\delta,k} \sim \mathrm{Normal}^+(0, 1),\\ &\kappa \sim \mathrm{LogNormal}(\log 200, 0.7).\\[6pt] &\textbf{Likelihood:}\\ &\mathbf{Y}_j \mid \mathbf{p}_j, \kappa \sim \mathrm{Dirichlet\text{-}Multinomial}(n_j,\;\kappa\,\mathbf{p}_j). \end{aligned} \]

El GP multivariado se implementa via el Linear Model of Coregionalization (LMC): la covarianza total es el producto de Kronecker entre la covarianza temporal (\(K_t\)) y la covarianza entre candidatos (\(\mathrm{diag}(\boldsymbol{\alpha})\,\Omega_{GP}\,\mathrm{diag}(\boldsymbol{\alpha})\)). Esto hace al modelo separable, permitiendo la parametrización no-centrada eficiente y el cómputo de la media posterior en la grilla de predicción vía \(\hat{f}_{\text{pred}} = K(t_*, t)\,K_t^{-1}\,f_{\text{obs}}\).

Modelo

Ver código
// gaussiano.stan
// Dirichlet-Multinomial con Gaussian Process multivariado correlacionado
// Extiende la Cazuela: reemplaza la tendencia lineal con un GP suavizante
// cuya covarianza entre candidatos es estimada vía prior LKJ.
//
// Modelo de coregionalización lineal (LMC):
//   f[k, j] = alpha_k * (L_Omega_gp * z_gp)[k, :] @ L_t'
//   Cov(f_k(t), f_l(t')) = alpha_k * alpha_l * Omega_gp[k,l] * K_t(t, t')

functions {
  // Kernel cruzado K(x_pred, x_obs; rho), amplitud unitaria
  matrix kernel_cross(array[] real x_pred, array[] real x_obs, real rho) {
    int n1 = size(x_pred);
    int n2 = size(x_obs);
    matrix[n1, n2] K;
    for (i in 1:n1)
      for (j in 1:n2)
        K[i, j] = exp(-0.5 * square((x_pred[i] - x_obs[j]) / rho));
    return K;
  }
}

data {
  int<lower=1> J;                           // encuestas observadas
  int<lower=2> K;                           // candidatos (K-1 libres + referencia)
  int<lower=1> H;                           // encuestadoras
  array[J] int<lower=0> n;                  // tamaños muestrales
  array[J, K] int<lower=0> Y;              // conteos Y[j, k]
  array[J] real t_obs;                      // tiempos observados (escalados)
  array[J] int<lower=1, upper=H> house;     // índice de encuestadora

  // Grilla de predicción (pasado + futuro)
  int<lower=1> J_pred;
  array[J_pred] real t_pred;
}

parameters {
  vector[K - 1] mu;                          // interceptos base (log-ratio vs ref)
  real<lower=0> rho;                         // escala de longitud del GP (shared)
  vector<lower=0>[K - 1] alpha_gp;          // amplitud GP por candidato
  cholesky_factor_corr[K - 1] L_Omega_gp;   // correlación entre GPs de candidatos
  matrix[K - 1, J] z_gp;                    // pesos GP (parametrización no-centrada)

  // Efectos de casa multinivel (heredados de la Cazuela)
  matrix[K - 1, H] z_delta;
  vector<lower=0>[K - 1] sigma_delta;
  cholesky_factor_corr[K - 1] L_Omega_delta;

  real<lower=0> kappa;                       // concentración DM
}

transformed parameters {
  // Kernel GP sobre tiempos observados (amplitud unitaria; escala por alpha_gp)
  matrix[J, J] K_t = gp_exp_quad_cov(t_obs, 1.0, rho);
  for (j in 1:J) K_t[j, j] += 1e-9;       // jitter numérico
  matrix[J, J] L_t = cholesky_decompose(K_t);

  // GPs correlacionados: f = diag(alpha) * L_Omega * z_gp * L_t'
  matrix[K - 1, J] f_gp;
  {
    matrix[K - 1, J] z_corr = diag_pre_multiply(alpha_gp, L_Omega_gp * z_gp);
    f_gp = z_corr * L_t';
  }

  // Efectos de casa (non-centered)
  matrix[K - 1, H] delta = diag_pre_multiply(sigma_delta, L_Omega_delta) * z_delta;

  // Predictor lineal (log-ratio)
  matrix[J, K] eta;
  for (j in 1:J) {
    for (k in 1:(K - 1))
      eta[j, k] = mu[k] + f_gp[k, j] + delta[k, house[j]];
    eta[j, K] = 0;                          // candidato de referencia
  }

  // Simplex via softmax
  array[J] simplex[K] p;
  for (j in 1:J) p[j] = softmax(eta[j]');
}

model {
  // Priors GP
  mu ~ normal(0, 2);
  rho ~ normal(0.5, 0.3);                   // escala de longitud en tiempo escalado
  alpha_gp ~ normal(0, 1);
  L_Omega_gp ~ lkj_corr_cholesky(2);
  to_vector(z_gp) ~ std_normal();

  // Priors efectos de casa
  sigma_delta ~ normal(0, 1);
  L_Omega_delta ~ lkj_corr_cholesky(2);
  to_vector(z_delta) ~ std_normal();

  // Prior concentración
  kappa ~ lognormal(log(200), 0.7);

  // Likelihood Dirichlet-Multinomial
  for (j in 1:J)
    Y[j] ~ dirichlet_multinomial(kappa * to_vector(p[j]));
}

generated quantities {
  // Matrices de correlación
  corr_matrix[K - 1] Omega_gp = multiply_lower_tri_self_transpose(L_Omega_gp);
  corr_matrix[K - 1] Omega_delta = multiply_lower_tri_self_transpose(L_Omega_delta);

  // Media posterior del GP en la grilla de predicción
  // f_pred[j2, k] = K(t_pred, t_obs) * K_t^{-1} * f_gp[k, :]'
  matrix[J_pred, K - 1] f_gp_pred;
  {
    matrix[J_pred, J] K_star = kernel_cross(t_pred, t_obs, rho);
    for (k in 1:(K - 1)) {
      vector[J] f_k = f_gp[k]';
      f_gp_pred[, k] = K_star * mdivide_left_spd(K_t, f_k);
    }
  }

  // Proporciones predichas (sin efecto casa — tendencia "pura")
  array[J_pred] simplex[K] p_pred;
  for (j2 in 1:J_pred) {
    vector[K] eta_pred;
    for (k in 1:(K - 1))
      eta_pred[k] = mu[k] + f_gp_pred[j2, k];
    eta_pred[K] = 0;
    p_pred[j2] = softmax(eta_pred);
  }

  // Posterior predictive check
  array[J, K] int Y_rep;
  for (j in 1:J)
    Y_rep[j] = dirichlet_multinomial_rng(kappa * to_vector(p[j]), n[j]);
}

brms puede expresar el mismo modelo con una fórmula de alto nivel. Las diferencias respecto al modelo Stan son:

Aspecto Stan brms
Likelihood Dirichlet-Multinomial (\(\kappa\)) Multinomial (sin sobredispersión)
GPs entre candidatos LMC: \(\rho\) compartido, \(\Omega_{GP}\) correlacionado GP independiente por categoría
Efecto casa LKJ cruzado (\(\Omega_\delta\)) Independiente por categoría
Ver código
library(brms)

# Un fila por encuesta, con conteos y tiempo escalado como columnas
datos_brm <- dplyr::bind_cols(
  encuestas_meta,
  tibble::as_tibble(conteos_2026),
  tibble::tibble(time_scaled = time_scaled)
)

# GP suavizante por categoría + efecto de encuestadora
# brms genera un GP separado (lscale, sdgp propios) para cada log-ratio
form_brm <- brms::bf(
  cbind(cand_ic, cand_adle, cand_pv, cand_sf, cand_cl, cand_ruido) | trials(muestra) ~
    gp(time_scaled, scale = FALSE) + (1 | encuestadora)
)

# Priors aproximando los del modelo Stan
priors_brm <- c(
  brms::prior(normal(0, 2),     class = Intercept),
  brms::prior(normal(0.5, 0.3), class = lscale,   lb = 0),
  brms::prior(normal(0, 1),     class = sdgp,      lb = 0),
  brms::prior(normal(0, 1),     class = sd,        lb = 0)
)

gp_brms_fit <- brms::brm(
  form_brm,
  data    = datos_brm,
  family  = brms::multinomial(refcat = "cand_ruido"),
  prior   = priors_brm,
  seed    = 42,
  chains  = 4,
  cores   = 4,
  iter    = 5000,
  warmup  = 1000,
  control = list(adapt_delta = 0.95, max_treedepth = 12),
  backend = "cmdstanr"
)

# Tendencia pura (sin efecto casa) en la grilla de predicción
newdata_brm <- tibble::tibble(
  time_scaled  = time_pred_scaled,
  encuestadora = factor(NA, levels = levels(encuestas_meta$encuestadora)),
  muestra      = 1000L
)

pred_brm <- brms::posterior_epred(
  gp_brms_fit,
  newdata          = newdata_brm,
  allow_new_levels = TRUE,
  re_formula       = NA   # marginaliza sobre el efecto casa
)
1
Construimos el data frame para brms: metadatos de cada encuesta, conteos por candidato y el tiempo escalado.
2
Definimos la fórmula: un GP suavizante por categoría (gp(time_scaled)) más efecto aleatorio de encuestadora, con respuesta multinomial.
3
Definimos priors que aproximan los del modelo Stan.
4
Ajustamos el modelo con brms::brm() usando el backend cmdstanr.
5
Construimos la grilla de predicción (sin encuestadora, para marginalizar el efecto casa).
6
Obtenemos la tendencia “pura” proyectada con posterior_epred(), marginalizando el efecto de casa.

Comparación de modelos

Ajiaco2 Cazuela Gaussiano
Tendencia temporal No (pooled) Lineal (\(\beta_{1k}\,t\)) GP no-paramétrico \(f_k(t)\)
Forma de la tendencia — Línea recta Cualquier función suave
Correlación entre candidatos No No (en tendencias) Sí — \(\Omega_{GP}\)
Proyección a futuro No Extrapolación lineal GP predictivo con incertidumbre
Efecto casa No Sí, LKJ Sí, LKJ (igual)
Parámetros adicionales — \(\beta_{0k},\; \beta_{1k},\; L_{\Omega_\delta},\; \sigma_\delta\) \(\rho,\; \boldsymbol{\alpha}_{GP},\; L_{\Omega_{GP}},\; \mathbf{z}_{GP}\)
Interpretabilidad Muy alta (\(p\) = preferencias) Alta (\(\beta_{1k}\) = tendencia/día) Media (\(\rho\) = suavidad)

Resultado — primera vuelta 31 de mayo de 2026

NotaResultados oficiales
Candidato % Votos válidos
Abelardo de la Espriella 43.72%
Iván Cepeda 40.92%
Paloma Valencia 6.92%
Sergio Fajardo 4.26%
Claudia López 0.95%

El GP multivariado proyectaba la tendencia alcista de ADLE y la bajada de Paloma Valencia con correlaciones entre candidatos vía el prior LKJ. La proyección al 31 de mayo subestimó el resultado final de ADLE (43.72%) — la señal estaba en la dirección correcta, pero no en la magnitud. Ver evaluación completa en Café.

Cómo citar

BibTeX
@online{recetas_electorales2026,
  author = {{Recetas Electorales}},
  title = {🌊 Gaussiano},
  date = {2026-05-16},
  url = {https://recetas-electorales.netlify.app/elecciones/2026-colombia/2026-05-16-gaussiano/2026-gaussiano.html},
  langid = {es}
}
Por favor, cita este trabajo como:
Recetas Electorales. 2026. “🌊 Gaussiano.” May 16. https://recetas-electorales.netlify.app/elecciones/2026-colombia/2026-05-16-gaussiano/2026-gaussiano.html.