Modelo logit con efectos aleatorios para la segunda vuelta y una ñapa
Autor/a
Afiliación
Recetas Electorales
Análisis independiente
Fecha de publicación
3 de junio de 2026
Fecha de última modificación
22 de junio de 2026
“No amount of clever manipulation can ever produce inferential probabilities about a hypothesis purely from its sampling probabilities.” — Aubrey Clayton
Postre Logístico 2026
La segunda vuelta la disputan Abelardo de la Espriella, que ganó la primera vuelta con el 43.7% de los votos, e Iván Cepeda, que obtuvo el 40.9%. El Postre 2026 estima la probabilidad de que uno o el otro gane la segunda vuelta presidencial.
Ver código
library(tidyverse)library(cmdstanr)library(here)library(showtext)library(scales)library(ggdist)sysfonts::font_add_google("News Cycle", "news-cycle")showtext::showtext_auto()source(here("R", "theme_recetas.R"))# Fecha estimada de la segunda vueltafecha_2v <- lubridate::ymd("2026-06-22")# Encuestas post-primera vuelta (solo desde 2026-05-31) ----encuestas_2v <- readr::read_csv(here("elecciones", "2026-colombia", "2026-01-26-entrada", "encuestas_2026.csv"),show_col_types =FALSE) |> dplyr::mutate(fecha = lubridate::mdy(fecha)) |> dplyr::filter(fecha >= lubridate::ymd("2026-05-31")) |># CELAG 14 jun excluida de todos los modelos por decisión editorial dplyr::filter(!(encuestadora =="CELAG"& fecha == lubridate::ymd("2026-06-14"))) |> dplyr::mutate(encuestadora =factor(encuestadora),enc_id =as.integer(encuestadora),dd =as.numeric(fecha_2v - fecha),votos_ic =as.integer(round(cand_ic * muestra)),votos_adle =as.integer(round(cand_adle * muestra)),total12 = votos_ic + votos_adle )n_polls <-nrow(encuestas_2v)n_enc <- dplyr::n_distinct(encuestas_2v$enc_id)# Compilar modelo ----postre_stan <- cmdstanr::cmdstan_model(here("elecciones", "2026-colombia", "2026-06-03-postre", "postre2026_v2.stan"),force_recompile =FALSE)# Modelo único: votos_adle ~ Binomial(total12, p)# P(IC) = 1 − P(ADLE) por construcción → probabilidades de victoria suman exactamente 100%data_2v <-list(N = n_polls,N_enc = n_enc,votos_adle = encuestas_2v$votos_adle,votos_ic = encuestas_2v$votos_ic,enc_id = encuestas_2v$enc_id,dd = encuestas_2v$dd,mu_prior =qlogis(0.50) # prior neutro en P(ADLE | ADLE∪IC))# Ajustar modelo ----fit_2v <- postre_stan$sample(data = data_2v,seed =2026,chains =4,parallel_chains =4,iter_warmup =1000,iter_sampling =4000,adapt_delta =0.95,refresh =0)# Extraer distribuciones posteriores ----# p_adle y p_ic provienen del mismo posterior: suman 1 en cada muestrap_adle <-as.vector(fit_2v$draws("p_adle", format ="draws_matrix"))p_ic <-1- p_adleprob_win_adle <-round(100*mean(p_adle >0.5))prob_win_ic <-100- prob_win_adle # garantiza que sumen exactamente 100%med_adle <-round(100*median(p_adle), digits =1)med_ic <-round(100*median(p_ic), digits =1)ic90_adle <-round(100*quantile(p_adle, c(0.05, 0.95)), digits =1)ic90_ic <-round(100*quantile(p_ic, c(0.05, 0.95)), digits =1)
1
Cargamos los paquetes: tidyverse para datos, cmdstanr para el modelo, y los demás para fuentes, escalas y distribuciones.
2
Registramos la fuente, activamos showtext y cargamos el tema de marca.
3
Fijamos la fecha estimada de la segunda vuelta (22 de junio de 2026).
4
Leemos las encuestas, nos quedamos con las posteriores al 31 de mayo y calculamos votos absolutos y días a la segunda vuelta de cada finalista.
5
Contamos el número de encuestas y de encuestadoras distintas.
6
Compilamos el modelo Stan de la segunda vuelta.
7
Armamos la lista de datos para Stan (votos, encuestadora, días, prior neutro).
8
Ajustamos el modelo con muestreo MCMC (4 cadenas).
9
Extraemos la posterior de P(ADLE); por construcción P(IC) = 1 − P(ADLE).
10
Calculamos probabilidades de victoria, medianas e intervalos del 90% de cada candidato.
ImportantePronóstico actual — basado en 6 encuesta(s) post-primera vuelta
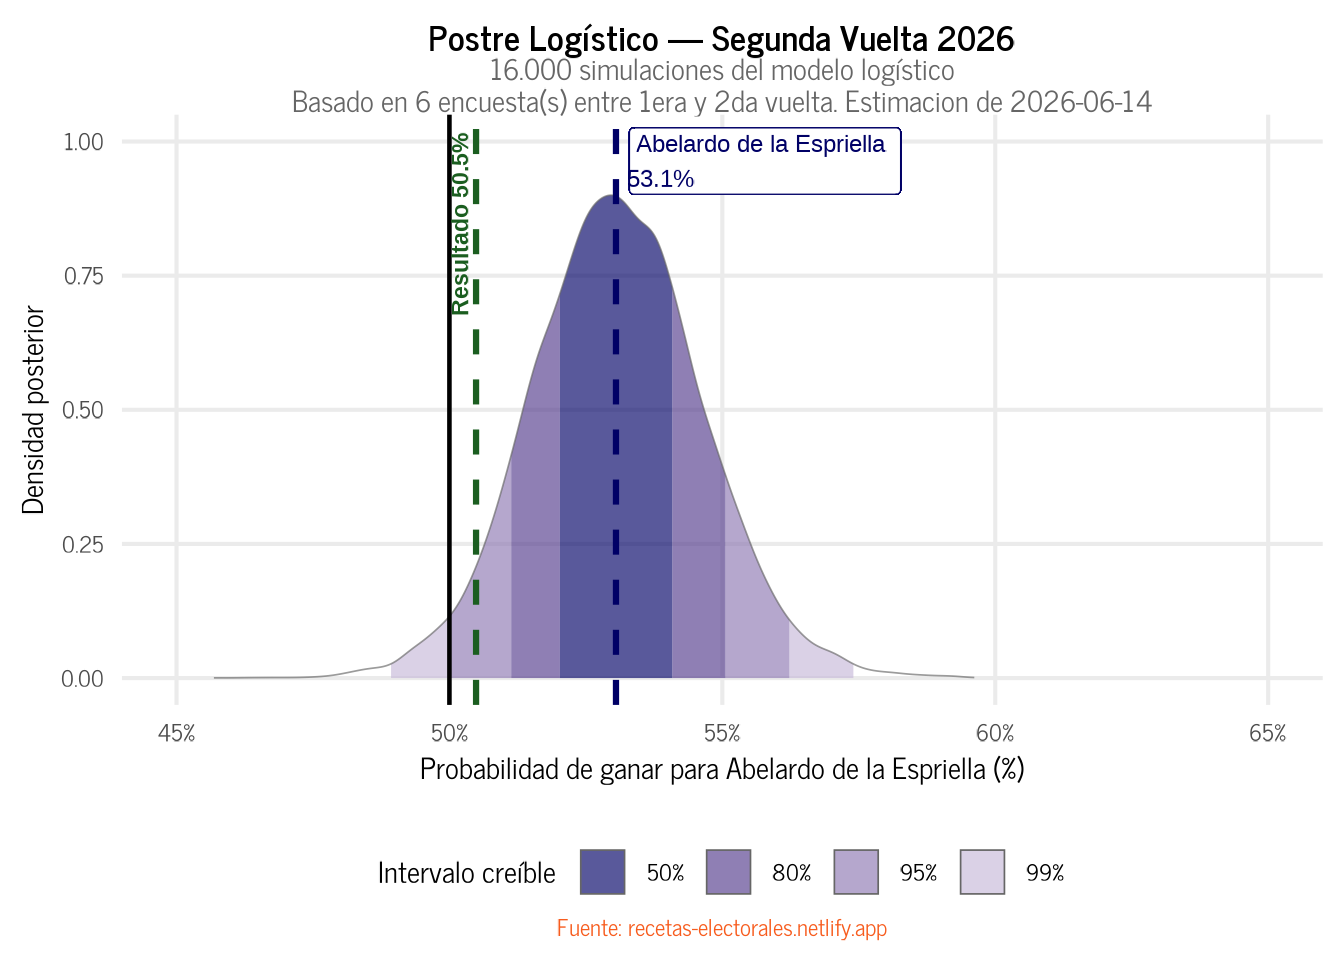
Abelardo de la Espriella tiene una probabilidad estimada de ganar de 97% (mediana: 53.1%; IC 90%: 50.6%–55.7%).
Figura 1: Distribuciones posteriores de intención de voto — segunda vuelta 2026
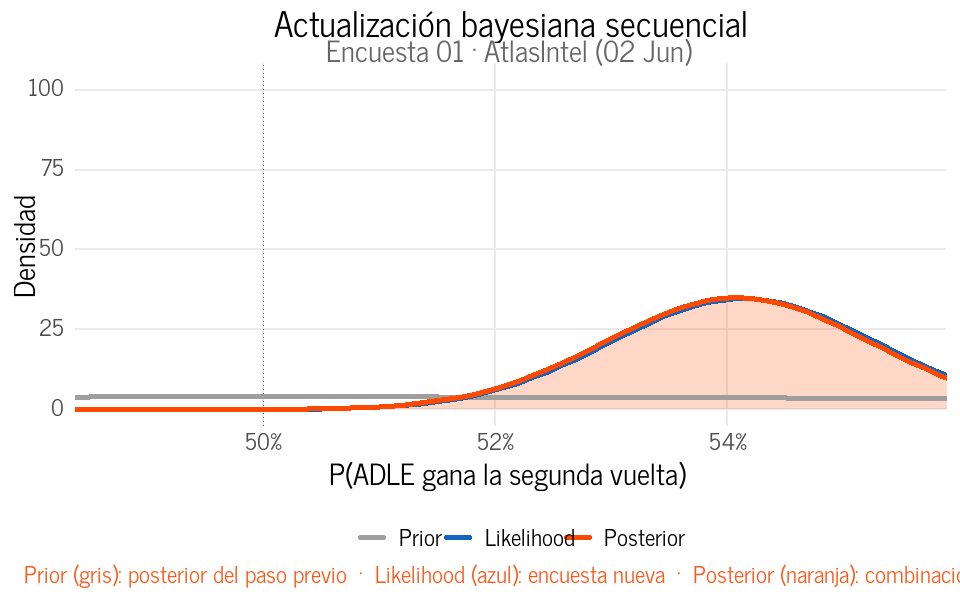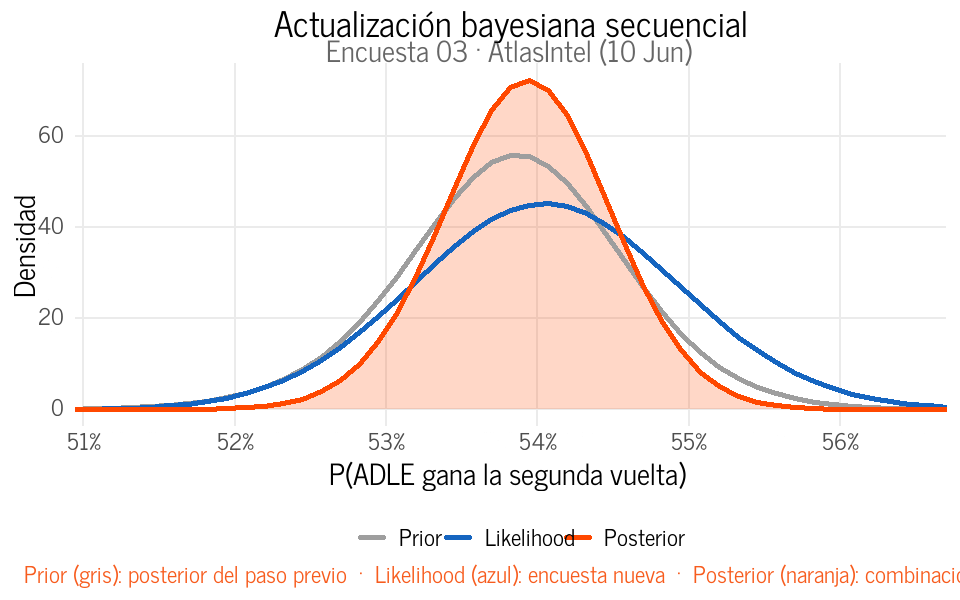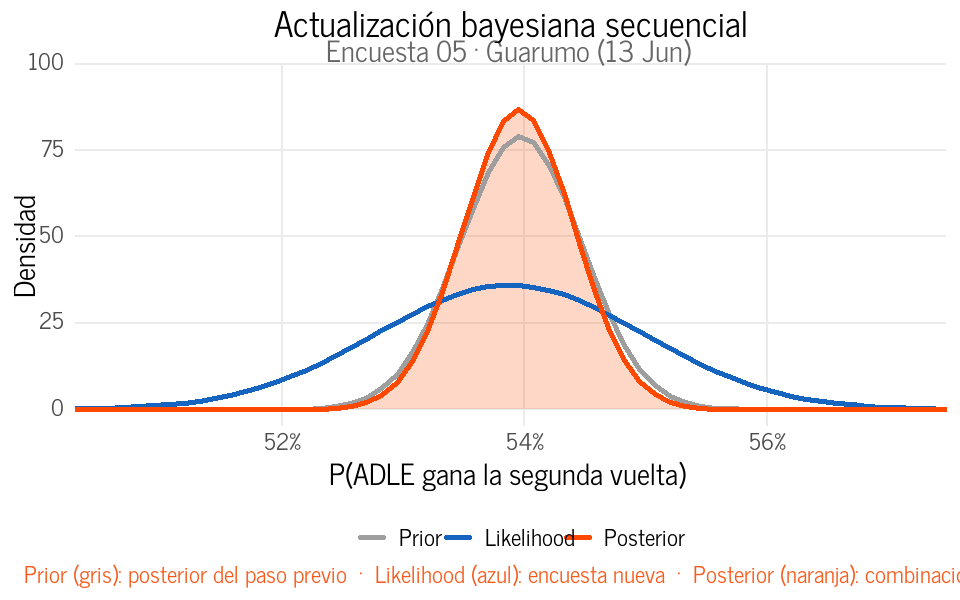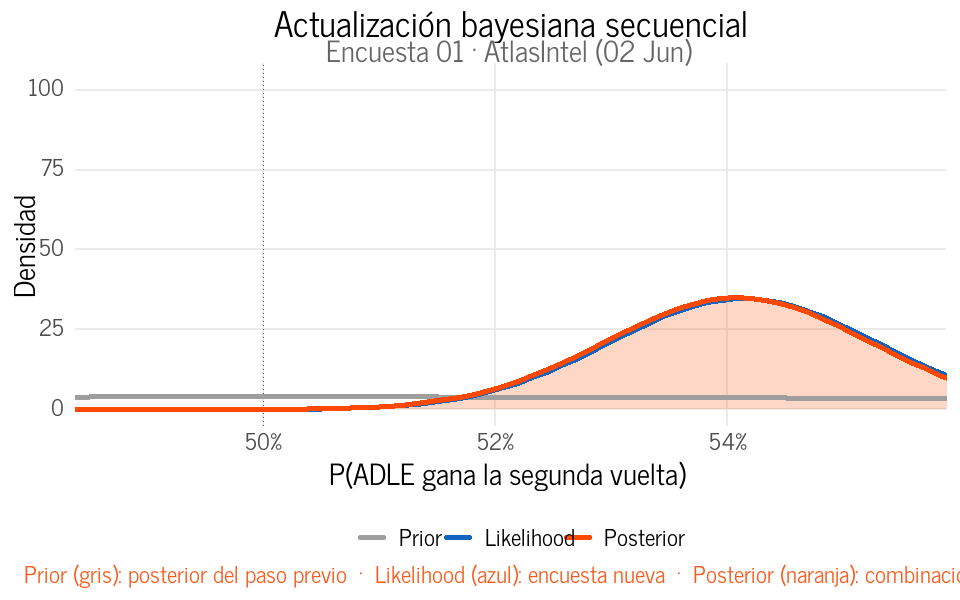
La siguiente animación muestra la actualización bayesiana encuesta a encuesta: el prior (gris) en cada paso es el posterior del paso anterior; el likelihood (azul) resume solo la encuesta nueva; el posterior (naranja) los combina mediante el teorema de Bayes. Así, el conocimiento se acumula secuencialmente: cada encuesta refina la distribución que dejó la anterior.
Para claridad visual, esta versión trata cada voto encuestado como observación directa de \(p\), el modelo Stan completo añade efectos aleatorios por encuestadora y un coeficiente de antigüedad.
Figura 2: Actualización bayesiana — Prior, likelihood y posterior encuesta a encuesta
Receta
El Postre modela la segunda vuelta como un problema binomial único. Para cada encuesta \(i\), el conteo de votos de ADLE entre quienes eligieron a uno de los dos finalistas se modela así:
El prior \(\bar\alpha \sim \textrm{Normal}(0, 0.40)\) es neutro: su media corresponde a un empate perfecto (50%-50%) y su escala 0.40 en logit equivale a ±8 puntos porcentuales al 68% de credibilidad. Los efectos aleatorios usan una parametrización no centrada (\(z_j\)) para mejorar la convergencia del MCMC.
NotaPriors
Parámetro
Prior
Valor central
\(\bar\alpha\)
\(\textrm{Normal}(0,\; 0.40)\)
50%
\(\sigma_{\textrm{enc}}\)
\(t_3^+(0,\; 0.25)\)
—
\(\beta_{dd}\)
\(\textrm{Normal}(0,\; 0.05)\)
0
El prior de \(\bar\alpha\) cubre de 38% a 62% al 90% de credibilidad (en escala de probabilidad), reflejando genuina incertidumbre sobre qué candidato recibirá más votos de los eliminados en la primera vuelta.
El prior de \(\beta_{dd}\) limita el efecto de la antigüedad de la encuesta a cambios pequeños por día: una escala de 0.05 en logit implica que una encuesta de hace 10 días desplaza la estimación a lo sumo ~2 puntos porcentuales.
Tip¿Por qué \(t_3^+\) para \(\sigma_{\textrm{enc}}\)?
\(\sigma_{\textrm{enc}}\) controla qué tan distintas pueden ser las encuestadoras entre sí. La \(t_3^+(0, 0.25)\) es el prior recomendado por Gelman para parámetros de escala en modelos multinivel: tiene colas más pesadas que la normal, lo que permite que \(\sigma_{\textrm{enc}}\) sea grande si los datos lo exigen. Con escala 0.25 en logit, el prior cubre sesgos de casa de hasta ±10 puntos porcentuales, consistente con lo observado históricamente en encuestas colombianas.
Estimación con cmdstanr
El modelo en Stan, que se compila y ajusta via cmdstanr:
Compilamos el modelo Stan de la segunda vuelta desde el archivo .stan.
2
Ajustamos el modelo con $sample(): pasamos los datos (votos, encuestadora, días, prior neutro) y la configuración del muestreo MCMC.
Distancia entre candidatos
El modelo logístico anterior estima la probabilidad de victoria de cada candidato, pero el margen entre ellos solo aparece de forma indirecta, como una transformación no lineal de \(\pi\). Para responder la pregunta “¿por cuántos puntos?” con su propia incertidumbre, agregamos una ñapa: un modelo que toma la distancia entre los dos finalistas como el parámetro a estimar.
Mientras el modelo logístico vive en la escala multiplicativa (el odds de ADLE), este modelo vive en la escala aditiva: la diferencia de puntos entre los dos candidatos. Es la receta complementaria — dos caminos distintos para estimar lo mismo. Que coincidan o no es, en sí, una buena prueba de consistencia.
Ver código
# Margen observado entre finalistas y su error de medición ----# q = share de ADLE entre los dos finalistas; d = margen (2q − 1) en [−1, 1]# s = error estándar de la diferencia de dos categorías (binomial entre finalistas)encuestas_dist <- encuestas_2v |> dplyr::mutate(q = votos_adle / total12,d =2* q -1,s =sqrt((1- d^2) / total12) )# Compilar modelo de distancia ----distancia_stan <- cmdstanr::cmdstan_model(here("elecciones", "2026-colombia", "2026-06-03-postre", "postre2026_distancia.stan"),force_recompile =FALSE)data_dist <-list(N = n_polls,N_enc = n_enc,d = encuestas_dist$d,s = encuestas_dist$s,enc_id = encuestas_dist$enc_id,dd = encuestas_dist$dd)fit_dist <- distancia_stan$sample(data = data_dist,seed =2026,chains =4,parallel_chains =4,iter_warmup =1000,iter_sampling =4000,adapt_delta =0.95,refresh =0)# Posterior de la distancia (margen el día de la elección, en puntos) ----distancia <-as.vector(fit_dist$draws("distancia", format ="draws_matrix"))med_dist <-round(100*median(distancia), digits =1)ic90_dist <-round(100*quantile(distancia, c(0.05, 0.95)), digits =1)prob_lidera <-round(100*mean(distancia >0))# Contraste con el modelo logístico: P(ADLE gana) = prob_win_adle (definido arriba)
1
Calculamos el margen observado entre finalistas d = 2q − 1 y su error de medición s, derivado de la varianza binomial de la diferencia (denominador: votos de los dos finalistas).
2
Compilamos el modelo Stan de la distancia.
3
Armamos la lista de datos para Stan (margen, error de medición, encuestadora, días).
4
Ajustamos el modelo con muestreo MCMC (4 cadenas), igual configuración que el logístico.
5
Extraemos la posterior de la distancia (margen el día de la elección, dd = 0) y calculamos mediana, IC 90% y la probabilidad de que ADLE lidere.
ImportanteDistancia estimada — margen entre los dos finalistas
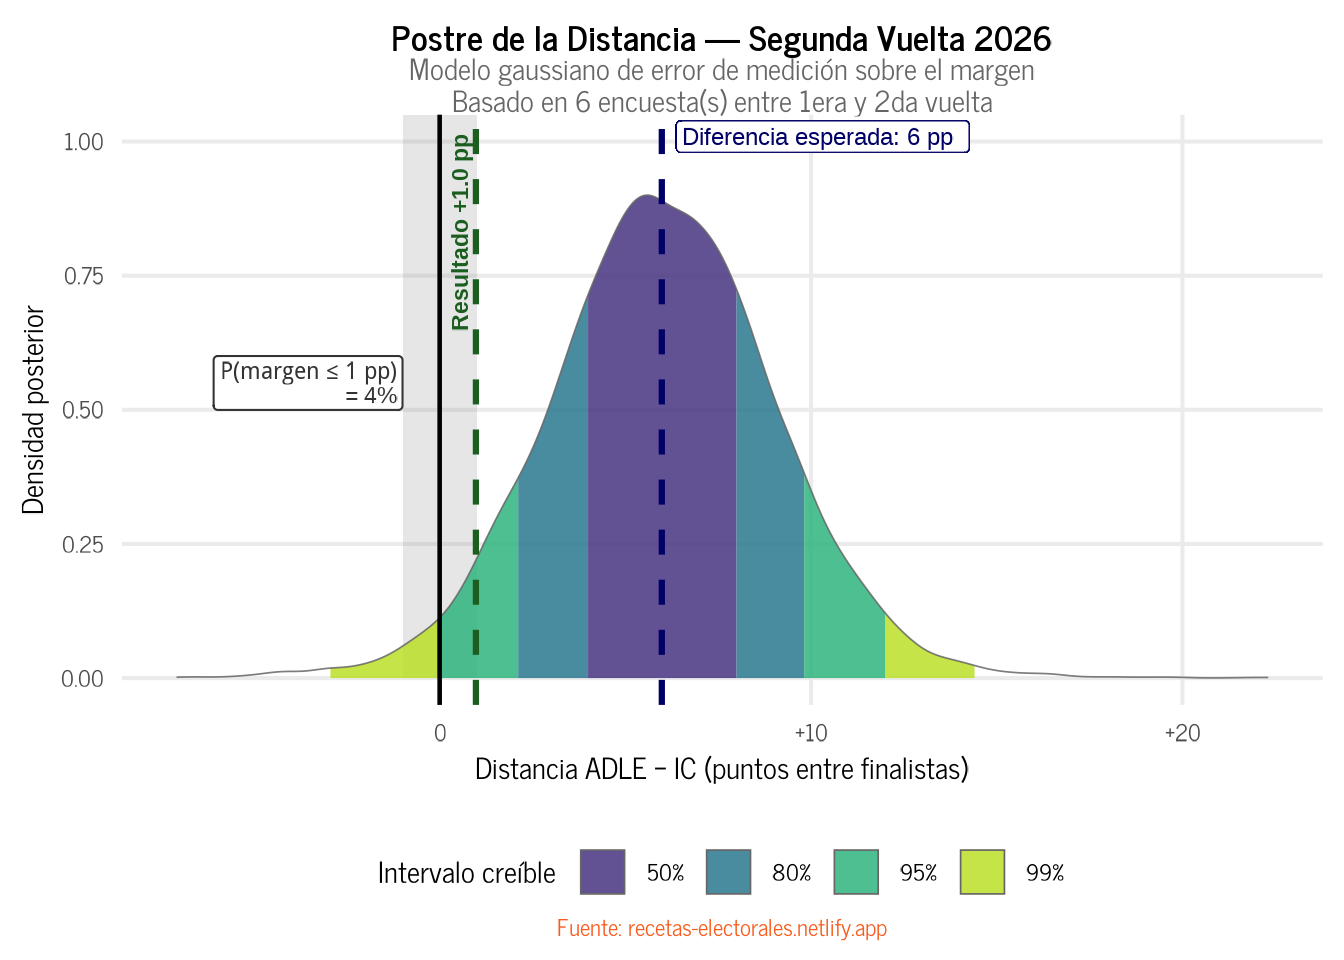
La ventaja estimada de Abelardo de la Espriella sobre Iván Cepeda es de 6.0 puntos (IC 90%: 1.0 a 11.0). El modelo asigna a ADLE una probabilidad de 97% de quedar por encima — frente al 97% del modelo logístico.
Figura 3: Distribución posterior de la distancia entre los dos finalistas — segunda vuelta 2026
Receta de la distancia
Para cada encuesta \(i\), sea \(q_i\) la proporción de ADLE entre los dos finalistas (\(q_i = N_i^{ADLE} / (N_i^{ADLE} + N_i^{IC})\)). El margen observado y su error de medición son:
El error \(s_i\) es la desviación estándar de la diferencia de dos categorías de una distribución multinomial, \(\sqrt{(p^{ADLE} + p^{IC} - d^2)/N}\), que entre los dos finalistas (donde \(p^{ADLE} + p^{IC} = 1\)) se reduce a la fórmula anterior. Como \(s_i\) es conocido (fijo desde los datos), el modelo es un jerárquico normal sobre el margen:
donde \(\bar\delta\) es la distancia esperada el día de la elección (\(dd = 0\)), \(\delta_{\textrm{enc}}\) son los sesgos de casa en escala de margen, y \(\gamma\) la deriva por día.
El prior \(\bar\delta \sim \textrm{Normal}(0, 0.16)\) está centrado en un empate (distancia cero) y cubre de −26 a +26 puntos al 90% de credibilidad, neutro dada la primera vuelta apretada (43.7% vs 40.9%). Como antes, los efectos de casa usan una parametrización no centrada (\(z_j\)).
NotaPriors del modelo de distancia
Parámetro
Prior
Valor central
\(\bar\delta\)
\(\textrm{Normal}(0,\; 0.16)\)
0 (empate)
\(\sigma_{\textrm{enc}}\)
\(t_3^+(0,\; 0.08)\)
—
\(\gamma\)
\(\textrm{Normal}(0,\; 0.01)\)
0
A diferencia del modelo logístico —que vive en la escala del odds—, aquí los parámetros se interpretan directamente en puntos de margen: \(\bar\delta = 0.05\) significa que ADLE aventaja a IC por 5 puntos entre los finalistas. El prior de \(\gamma\) limita la deriva diaria del margen a cambios pequeños (escala 0.01).
Tip¿Por qué un modelo de error de medición?
El margen \(s_i\) no es un parámetro a estimar: es la incertidumbre que la propia encuesta tiene por su tamaño de muestra, conocida desde los datos. Una encuesta grande (muestra mayor) pesa más en la estimación de \(\bar\delta\) que una pequeña, porque su \(s_i\) es menor. Así, el modelo pondera cada encuesta por su precisión muestral —algo que el conteo binomial del modelo logístico ya hace de forma implícita, y que aquí queda explícito sobre la distancia.
Meta-análisis con brms
Los dos modelos anteriores los escribimos a mano en Stan. Pero la idea central —combinar varias encuestas, cada una con su propia precisión, en una sola estimación del margen— tiene un nombre en estadística: meta-análisis de efectos aleatorios. Y es justo el tipo de modelo que brms ajusta en una sola línea, traduciendo la fórmula a Stan por debajo.
Tomamos el mismo margen observado \(d_i\) y su error de medición conocido \(s_i\) del modelo de distancia, y se los pasamos a brms con el término de adición se(), que le dice al modelo que cada encuesta trae su propia desviación estándar fija. Los efectos aleatorios (1 | encuestadora) capturan la heterogeneidad entre casas encuestadoras —el equivalente al \(\tau\) del meta-análisis clásico. A diferencia del modelo de distancia en Stan, esta versión omite la deriva temporal y trata todas las encuestas post-primera vuelta como estimaciones intercambiables del mismo margen.
Ver código
library(brms)library(tidybayes)# Mismo margen d y error de medición s del modelo de distanciadatos_meta <- encuestas_2v |> dplyr::mutate(q = votos_adle / total12,d =2* q -1,s =sqrt((1- d^2) / total12) )# Priors equivalentes a los del modelo de distancia en Stanpriors_meta <-c( brms::prior(normal(0, 0.16), class ="Intercept"), brms::prior(student_t(3, 0, 0.08), class ="sd"))# Meta-análisis de efectos aleatorios: d_i ~ Normal(theta_i, s_i)fit_meta <- brms::brm( d |se(s, sigma =FALSE) ~1+ (1| encuestadora),data = datos_meta,family =gaussian(),prior = priors_meta,seed =2026,chains =4,cores =4,iter =5000,warmup =1000,control =list(adapt_delta =0.95),backend ="cmdstanr",refresh =0)# Posterior del margen combinado (intercepto = margen pooled) ----post_meta <- fit_meta |> tidybayes::spread_draws(b_Intercept) |> dplyr::pull(b_Intercept)med_meta <-round(100*median(post_meta), digits =1)ic90_meta <-round(100*quantile(post_meta, c(0.05, 0.95)), digits =1)prob_meta <-round(100*mean(post_meta >0))
1
Cargamos brms, que traduce la fórmula a Stan y la ajusta con el backend cmdstanr (el mismo que usamos en el resto del artículo), y tidybayes para extraer la posterior en formato ordenado.
2
Reconstruimos el margen d = 2q − 1 y su error de medición s desde las encuestas, idéntico al modelo de distancia.
3
Fijamos priors equivalentes a los del modelo de distancia: intercepto Normal(0, 0.16) y desviación entre encuestadoras t_3^+(0, 0.08).
4
Ajustamos el meta-análisis: d | se(s) indica que cada encuesta aporta su error de medición conocido, y (1 | encuestadora) añade la heterogeneidad entre casas.
5
Con tidybayes::spread_draws() extraemos la posterior del intercepto b_Intercept —el margen combinado— en formato ordenado (una fila por muestra) y calculamos mediana, IC 90% y la probabilidad de que ADLE lidere.
ImportanteMeta-análisis brms — margen combinado
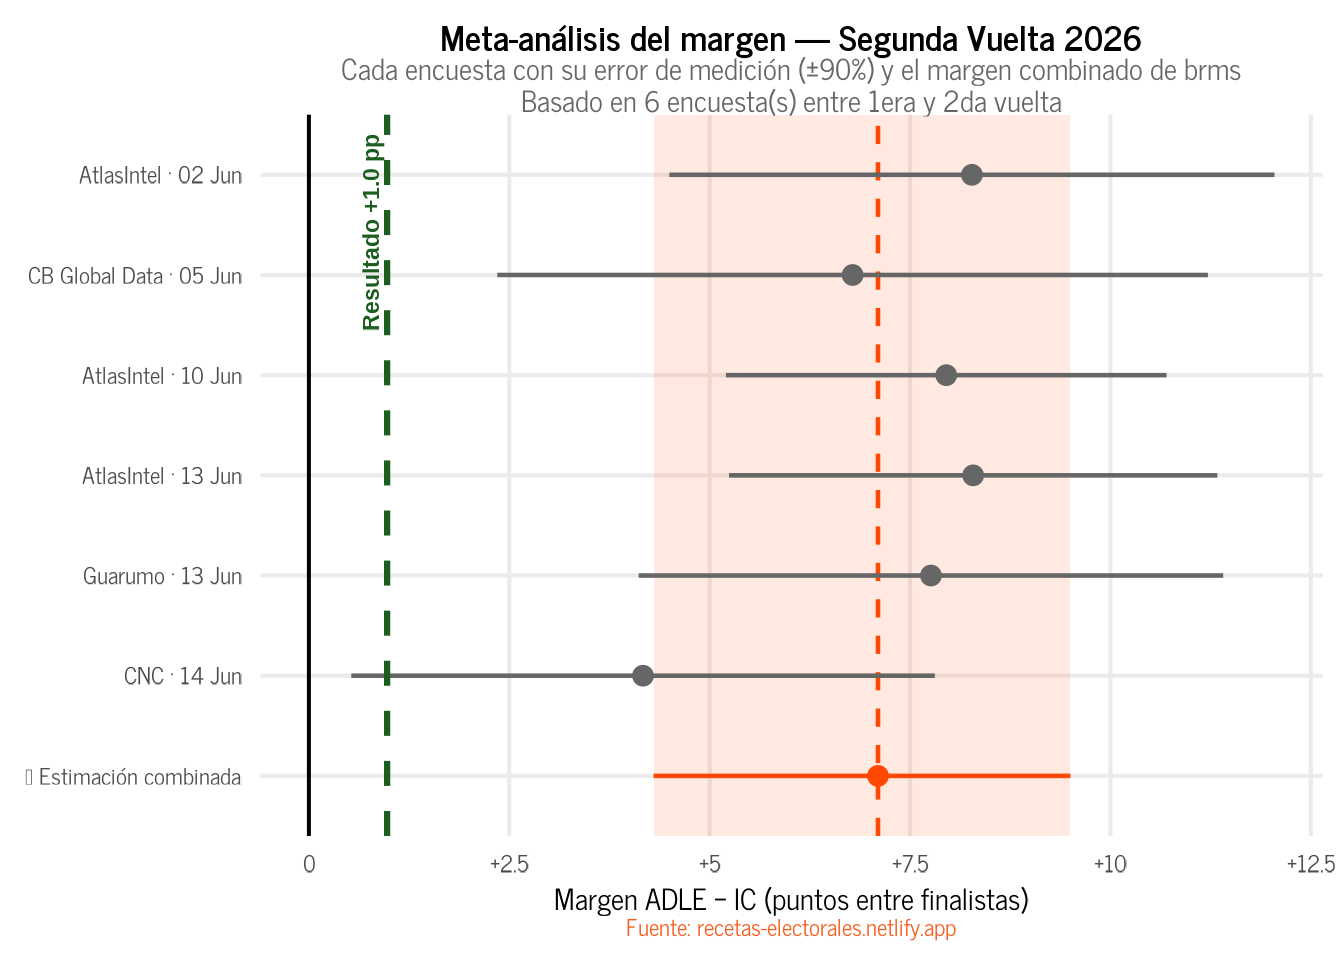
El meta-análisis de efectos aleatorios estima una ventaja de Abelardo de la Espriella de 7.1 puntos (IC 90%: 4.3 a 9.5), con una probabilidad del 100% de quedar por encima de Iván Cepeda. El resultado coincide con el modelo de distancia en Stan (6.0 puntos): son la misma receta en dos cocinas distintas.
El forest plot es la figura canónica del meta-análisis: cada encuesta aporta su estimación del margen con su barra de incertidumbre (±90%), y la franja naranja marca el margen combinado que brms infiere de todas ellas a la vez.
Figura 4: Forest plot del meta-análisis del margen — segunda vuelta 2026
Receta del meta-análisis
El meta-análisis de efectos aleatorios es, formalmente, el mismo modelo jerárquico normal de la distancia, pero expresado en el lenguaje del meta-análisis. Para cada encuesta \(i\) con margen observado \(d_i\) y error de medición conocido \(s_i\):
Aquí \(\mu\) es el margen combinado (lo que brms reporta como b_Intercept), \(\tau\) es la heterogeneidad entre encuestadoras, y cada \(s_i\) —fijo desde los datos— pondera cada encuesta por su precisión muestral. La fórmula d | se(s, sigma = FALSE) ~ 1 + (1 | encuestadora) codifica exactamente estas líneas: se(s) fija los \(s_i\), 1 es \(\mu\) y (1 | encuestadora) son los \(u_j\).
Tip¿Por qué sigma = FALSE?
Por defecto, un modelo gaussiano de brms estima una desviación residual \(\sigma\) además de la estructura de la media. Al escribir se(s, sigma = FALSE) le decimos que toda la dispersión a nivel de encuesta ya está contenida en el error de medición conocido \(s_i\): no hay ruido residual adicional que estimar. La única variación libre es \(\tau\), la heterogeneidad entre casas encuestadoras. Esto reproduce el modelo de error de medición de la distancia, ahora en una línea de brms.
Ajiaco2 de segunda vuelta
Los modelos anteriores condicionan en los dos finalistas: renormalizan los votos como si ADLE e IC fueran las únicas opciones. Pero en la segunda vuelta hay una tercera respuesta que esos modelos esconden en el denominador: el voto en blanco. Quien piensa votar en blanco no apoya a ninguno de los dos, y su peso puede mover el resultado.
Para darle su lugar, traemos de vuelta el ajiaco —el modelo Dirichlet-multinomial de la primera vuelta (🍲 Ajiaco 2)— pero ahora con solo tres ingredientes: Abelardo de la Espriella, Iván Cepeda y el voto en blanco. El mismo ajiaco2.stan, sin cambios, estima el simplex de preferencias sobre estas tres opciones, agrupando todas las encuestas y ponderando por su tamaño muestral.
Ver código
# Tres categorías: ADLE, IC y voto en blanco ----Y_2v <- encuestas_2v |> dplyr::transmute(adle = votos_adle,ic = votos_ic,blanco =as.integer(round(voto_blanco * muestra)) ) |>as.matrix()data_ajiaco2 <-list(J =nrow(Y_2v),K =3L,n =as.integer(rowSums(Y_2v)),Y = Y_2v)# Reutilizamos el mismo modelo de la primera vuelta, sin cambiosajiaco2_stan <- cmdstanr::cmdstan_model(here("elecciones", "2026-colombia", "2026-01-28-ajiaco2", "ajiaco2.stan"),force_recompile =FALSE)fit_ajiaco2_2v <- ajiaco2_stan$sample(data = data_ajiaco2,seed =2026,chains =4,parallel_chains =4,iter_warmup =1000,iter_sampling =4000,adapt_delta =0.95,refresh =0)# Posterior del simplex de preferencias (p[1]=ADLE, p[2]=IC, p[3]=blanco) ----p_draws <- fit_ajiaco2_2v$draws("p", format ="draws_matrix")p_adle_a <-as.vector(p_draws[, 1])p_ic_a <-as.vector(p_draws[, 2])p_blanco_a <-as.vector(p_draws[, 3])med_adle_a <-round(100*median(p_adle_a), digits =1)med_ic_a <-round(100*median(p_ic_a), digits =1)med_blanco_a <-round(100*median(p_blanco_a), digits =1)prob_adle_a <-round(100*mean(p_adle_a > p_ic_a))
1
Construimos la matriz de conteos Y con tres columnas —ADLE, IC y voto en blanco— convirtiendo cada porcentaje en votos absolutos.
2
Armamos la lista de datos para Stan: J encuestas, K = 3 opciones, tamaño muestral n (suma de las tres) y la matriz Y.
3
Compilamos el mismoajiaco2.stan de la primera vuelta, sin ninguna modificación.
4
Ajustamos el modelo Dirichlet-multinomial con muestreo MCMC (4 cadenas).
5
Extraemos la posterior del simplex p: las tres preferencias suman 1 en cada muestra.
ImportanteAjiaco de segunda vuelta — con voto en blanco
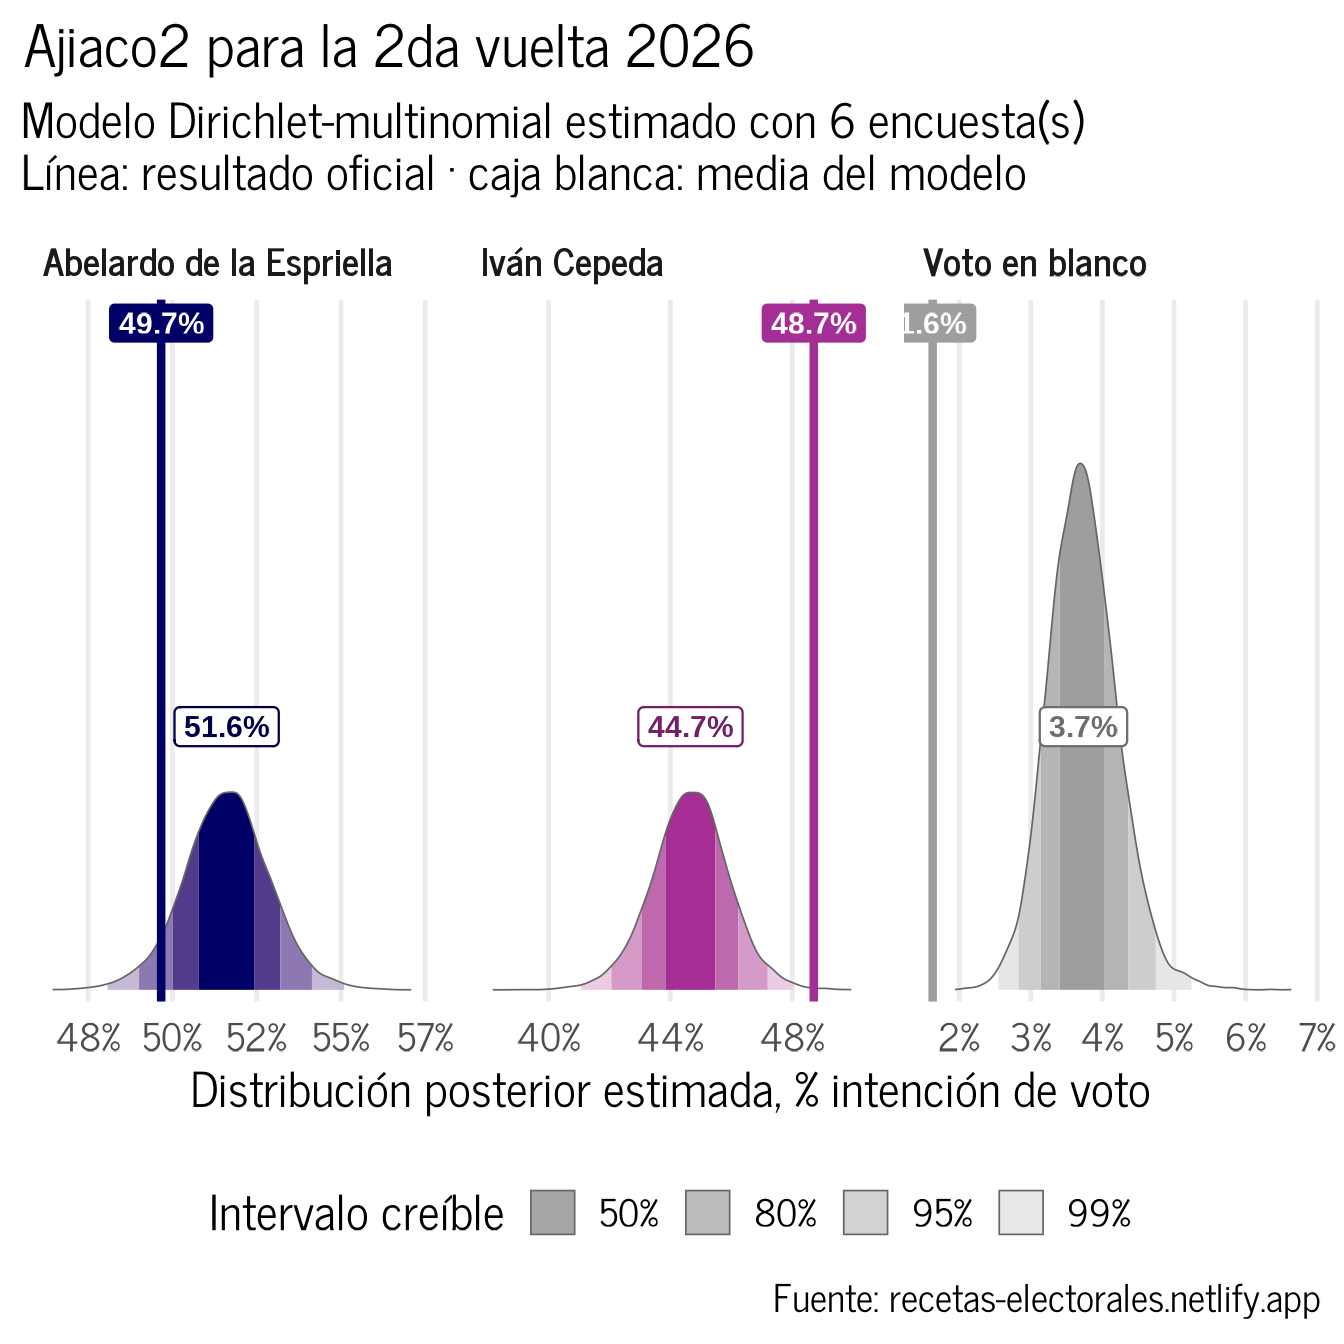
Incluyendo el voto en blanco como tercera opción, el modelo estima 51.6% para Abelardo de la Espriella, 44.7% para Iván Cepeda y 3.7% de voto en blanco. ADLE supera a IC con probabilidad del 100%.
Figura 5: Distribuciones posteriores de las tres opciones — ajiaco de segunda vuelta 2026
Receta del ajiaco
Para cada encuesta \(j\), los conteos de votos entre las tres opciones —ADLE, IC y blanco— se modelan con una verosimilitud Dirichlet-multinomial, que añade sobredispersión sobre el multinomial clásico para absorber el hecho de que las encuestas varían más entre sí de lo que predeciría el azar muestral:
El vector \(\mathbf{p} = (p_{ADLE}, p_{IC}, p_{blanco})\) es el simplex de preferencias agrupado —suma exactamente 1— y \(\kappa\) controla la concentración: valores altos significan encuestas muy parecidas entre sí, valores bajos, encuestas dispersas.
A diferencia del modelo logístico y del de distancia, que condicionan en los dos finalistas, aquí el voto en blanco compite por su parte del simplex. Por eso las cifras de ADLE e IC son algo menores: su denominador ahora incluye a quienes no eligen a ninguno de los dos.
Nota¿Por qué reutilizar el mismo modelo?
ajiaco2.stan no asume ningún número fijo de candidatos: el simplex p tiene dimensión K, que se pasa como dato. En la primera vuelta K valía 10; aquí vale 3. El mismo archivo, sin editar una sola línea, sirve para ambas. Es la ventaja de escribir modelos parametrizados por sus dimensiones en lugar de codificar el número de categorías a mano.
Resultado oficial
NotaResultado oficial — ganó Abelardo de la Espriella
Entre los dos finalistas, Abelardo de la Espriella obtuvo 50.5% (margen de +1.0 pp sobre Iván Cepeda); el voto en blanco fue 1.6%. La estimación central de cada modelo frente al resultado:
Modelo
ADLE estimado
ADLE real
Error (pp)
Logístico
53.1%
50.5%
+2.6
Distancia
53.0%
50.5%
+2.5
Meta-análisis brms
53.5%
50.5%
+3.0
Ajiaco2 (finalistas)
53.6%
50.5%
+3.1
El ☕ Café calcula las métricas formales de precisión (MAE, RMSE, cobertura) de estos modelos.