Las encuestas son telescopios: con una muestra pequeña no se ven objetos pequeños. ¿Tienen el alcance suficiente para ver diferencias en la segunda vuelta 2026?
Autor/a
Afiliación
Recetas Electorales
Análisis independiente
Fecha de publicación
7 de junio de 2026
Fecha de última modificación
22 de junio de 2026
“We show that despite over 50 years of reviews of low statistical power and its consequences, there has been no detectable increase..” — McElreath & Smaldino
Las encuestas funcionan como un telescopio: Con una muestra pequeña se detectan solo los grandes fenómenos, los grandes objetos celestiales, pero los pequeños son invisibles excepto para los telescopios más poderosos. Una diferencia de 10 puntos porcentuales entre 2 candidatos es una diferencia que un telescopio pequeño puede detectar; una diferencia de 1 o 2 puntos es invisible hasta para los telescopios poderosos. La señal existe; el instrumento sencillamente no tiene la resolución para captarla.
En la 🥗 Ensalada de 2018 mostramos que las encuestas del plebiscito de 2016 eran telescopios demasiado pequeños para ver la diferencia de 0.43% entre el Sí y el No. Lo mismo ocurrió en la segunda vuelta de 2022: el margen de 3.13% entre Petro y Hernández quedó por debajo del límite de resolución de los instrumentos disponibles. Ahora en la segunda vuelta de 2026 entre Iván Cepeda y Abelardo de la Espriella la pregunta es la misma: ¿tendrán las encuestas el alcance necesario?
Durante la campaña las encuestas daban a Abelardo de la Espriella una ventaja cómoda —cercana a 8 puntos—, un objeto que cualquier telescopio podía ver. Pero el 21 de junio el resultado fue un margen de apenas 0.96 puntos (ADLE 49.66% – IC 48.70%): un objeto aún más tenue que el de 2022 y, como veremos, invisible para los instrumentos disponibles. En esta entrada usamos power analysis para mostrar por qué, con una diferencia tan pequeña, que las encuestadoras acertaran el ganador fue esencialmente suerte.
El límite de resolución
El mínimo efecto detectable (MED) es el equivalente estadístico del límite de resolución de un telescopio: la diferencia electoral más pequeña que una encuesta de tamaño \(n\) puede distinguir del ruido de muestreo. Con una muestra pequeña solo se detectan ventajas muy grandes; diferencias de pocos puntos porcentuales quedan por debajo del umbral de visibilidad del instrumento.
El MED se deriva del tamaño del efecto de Cohen \(h\) para proporciones. Para una prueba de una proporción \(p\) contra el valor nulo \(p_0 = 0.5\) (empate entre candidatos):
donde \(h_{\text{obs}} = \left|2\arcsin\!\sqrt{p_{\text{obs}}} - \pi/2\right|\) y \(\Phi\) es la acumulada normal estándar. Los cálculos usan el paquete pwr de R.
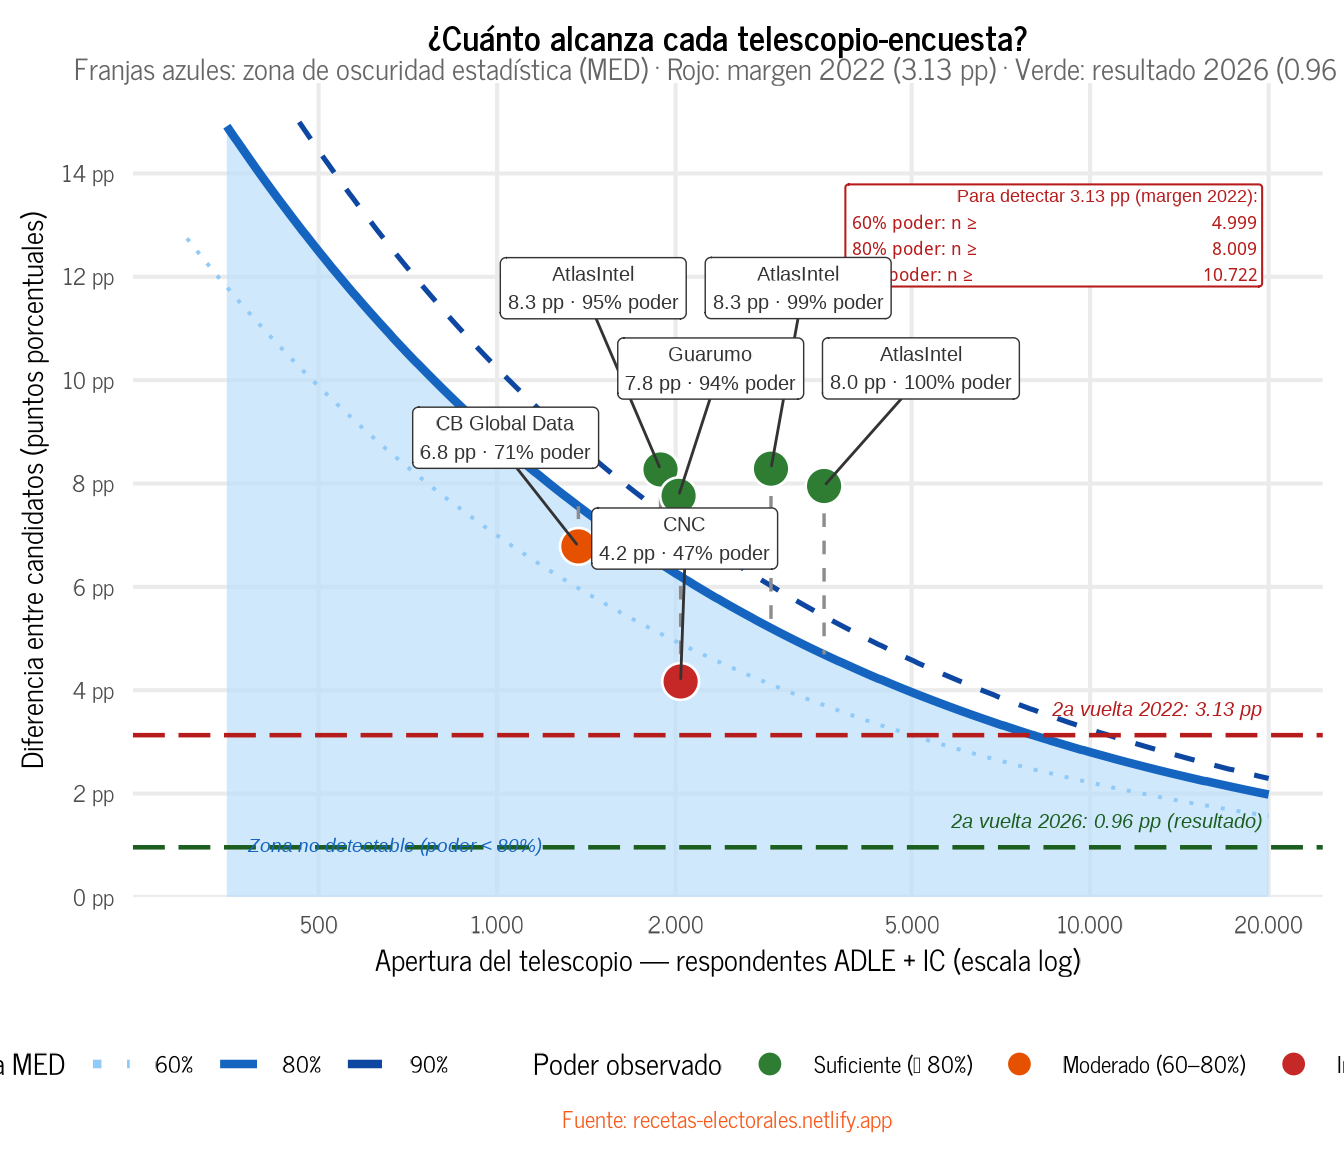
La gráfica muestra las zonas de oscuridad estadística del telescopio-encuesta: las tres franjas azules son regiones donde el instrumento no tiene resolución suficiente para ver la diferencia. La franja más oscura corresponde a poder menor al 60% — objetos invisibles incluso con el umbral más bajo; la intermedia al rango 60–80%; la más clara al 80–90%. Un punto de encuesta que cae sobre todas las franjas tiene poder observado superior al 90% — el telescopio ve el objeto con nitidez. El segmento punteado indica la brecha entre la diferencia registrada y el umbral de resolución al 80%.
Como referencia histórica se incluye el margen de la segunda vuelta 2022 (Petro 50.44% – Hernández 47.31% = 3.13 pp) en rojo: un objeto tan tenue que ninguno de los telescopios de la época tenía el alcance para verlo. La caja roja indica el tamaño mínimo de muestra que habría hecho falta.
La Tabla 1 traduce el gráfico a números concretos para cada encuesta. La última columna añade el dato decisivo: el poder de cada encuesta para detectar una diferencia de apenas 1 punto porcentual —el orden de magnitud del resultado real—, que cae muy por debajo del 80% en todos los casos.
Ver código
library(tidyverse)library(pwr)library(here)library(showtext)library(scales)library(ggrepel)library(kableExtra)sysfonts::font_add_google("News Cycle", "news-cycle")showtext::showtext_auto()source(here("R", "theme_recetas.R"))fecha_2v <- lubridate::ymd("2026-06-22")encuestas_2v <- readr::read_csv(here("elecciones", "2026-colombia", "2026-01-26-entrada", "encuestas_2026.csv"),show_col_types =FALSE) |> dplyr::mutate(fecha = lubridate::mdy(fecha)) |> dplyr::filter(fecha >= lubridate::ymd("2026-05-31")) |># CELAG 14 jun excluida de todos los modelos por decisión editorial dplyr::filter(!(encuestadora =="CELAG"& fecha == lubridate::ymd("2026-06-14"))) |> dplyr::mutate(encuestadora =factor(encuestadora),votos_ic =as.integer(round(cand_ic * muestra)),votos_adle =as.integer(round(cand_adle * muestra)),total12 = votos_ic + votos_adle )# Resultado oficial de la segunda vuelta (21 jun 2026) ----res_adle_2v <-49.66res_ic_2v <-48.70diff_real <- res_adle_2v - res_ic_2v # 0.96 pp (diferencia cruda)p_real <- res_adle_2v / (res_adle_2v + res_ic_2v) # share ADLE entre finalistash_real <-abs(pwr::ES.h(p_real, 0.5)) # tamaño de efecto de Cohen del margen real# Diferencia de referencia de 1 punto porcentual (0.5 vs 0.505) ----diff_ref_1pp <-1.0h_1pp <-abs(pwr::ES.h(0.5+ diff_ref_1pp /200, 0.5))
1
Cargamos los paquetes: tidyverse para manipulación de datos, pwr para el power analysis, y los demás para fuentes, escalas, etiquetas y tablas.
2
Registramos la fuente News Cycle y activamos showtext para que los gráficos usen la tipografía de marca.
3
Cargamos el tema visual común (theme_recetas()) y la paleta de candidatos.
4
Fijamos la fecha de la segunda vuelta (22 de junio de 2026).
5
Leemos la base de encuestas desde el CSV de la entrada de 2026.
6
Convertimos la fecha de texto (formato mes-día-año) a tipo fecha.
7
Nos quedamos solo con las encuestas posteriores al 31 de mayo (segunda vuelta).
8
Calculamos los votos absolutos de cada candidato y el total de la muestra de los dos finalistas.
9
Registramos el resultado oficial de la segunda vuelta y derivamos el margen real (0.96 pp), la share de ADLE entre finalistas y su tamaño de efecto de Cohen.
10
Fijamos una diferencia de referencia de 1 punto porcentual (0.5 vs 0.505) y su tamaño de efecto de Cohen, para medir el poder de cada encuesta frente a un margen tan estrecho.
Figura 1: Mínimo efecto detectable y poder estadístico observado — segunda vuelta 2026
¿Cuánto alcance tiene cada telescopio?
Tabla 1: Alcance de cada telescopio-encuesta — segunda vuelta 2026 (poder 80%, α = 0.05), con el poder para detectar una diferencia de 1 pp
Encuestadora
Fecha
n efectivo
Dif. obs. (pp)
MED 80% (pp)
Poder obs.
Poder 1 pp
≥ MED
AtlasIntel
10 Jun
3.559
8.0
4.7
100%
9%
✓
AtlasIntel
13 Jun
2.896
8.3
5.2
99%
8%
✓
AtlasIntel
02 Jun
1.886
8.3
6.4
95%
7%
✓
Guarumo
13 Jun
2.023
7.8
6.2
94%
7%
✓
CB Global Data
05 Jun
1.371
6.8
7.6
71%
7%
✗
CNC
14 Jun
2.039
4.2
6.2
47%
7%
✗
MED 80%: diferencia mínima detectable con poder 80% y significancia 95% (\u03b1 = 0.05, dos colas). Poder obs.: poder para detectar la diferencia que la propia encuesta registró. Poder 1 pp: poder para detectar una diferencia de 1 punto porcentual (azul). Verde = encuesta puede detectar su propia diferencia observada; rojo = no puede.
El veredicto: las encuestadoras tuvieron suerte
El 21 de junio, Abelardo de la Espriella ganó con 49.66% frente al 48.70% de Iván Cepeda: una diferencia de 0.96 puntos, más estrecha aún que el 3.13 pp de la segunda vuelta de 2022 y comparable al 0.43% del plebiscito de 2016. El objeto resultó ser mucho más tenue de lo que sugerían las encuestas, que durante la campaña daban a ADLE una ventaja de unos 8 puntos.
¿Qué tan posible era ver una diferencia tan pequeña? Calculamos, para cada encuesta de segunda vuelta, dos cantidades sobre el margen real de 0.96 pp: la probabilidad de que la encuesta siquiera apuntara al ganador correcto, y su poder estadístico para detectar esa diferencia con significancia.
ImportanteAcertar el ganador fue, esencialmente, un volado
Con una diferencia real de 0.96 pp, una encuesta del tamaño típico de la segunda vuelta (≈ 2.296 respondentes entre los dos finalistas) tenía apenas un 68% de probabilidad de siquiera apuntar al ganador correcto —poco más que lanzar una moneda— y un poder estadístico de solo 8% para detectar esa diferencia con significancia estadística.
Para distinguir 0.96 pp de un empate con 80% de poder habrían hecho falta 82.393 respondentes: unas 36 veces el tamaño de las muestras reales. Ninguna encuesta se acercó a ese alcance.
Que las encuestadoras hayan acertado el ganador no fue resolución del instrumento: fue suerte. El telescopio nunca tuvo el alcance para ver un objeto tan tenue; apuntó en la dirección correcta por azar.
Cómo citar
BibTeX
@online{recetas_electorales2026,
  author = {{Recetas Electorales}},
  title = {🧀 fromage},
  date = {2026-06-07},
  url = {https://recetas-electorales.netlify.app/elecciones/2026-colombia/2026-06-07-fromage/2026-fromage.html},
  langid = {es}
}